
pKa、logD 等理化参数如何决定你的化合物 ADMET 命运?
"这个化合物活性很好,但一进体内就被代谢掉了……""hERG 风险太高,这个系列不敢往下推了……"药物化学家对这些困境再熟悉不过。药物研发的高淘汰率,很大程度上源于对化合物 ADMET(吸收、分布、代谢、排泄、毒性)性质缺乏早期预判。理化参数——pKa、logD、ClogP、分子量——恰恰是决定这些性质的关键变量。问题是,你的化合物落在"安全区"吗?
01 来自 Biogen 的大数据分析
2021 年,Biogen(百健)药物化学团队在 Bioorganic & Medicinal Chemistry Letters 上发表了一项研究:利用超过 20,000 个内部化合物的体外 ADME 数据,系统分析了理化性质对 ADMET 谱的影响(Ma et al., Bioorg. Med. Chem. Lett. 2021, 36, 127825)。
该研究覆盖了药物研发中最关键的五个体外 ADME 终点:
- 血浆蛋白结合率(PPB,人/小鼠/大鼠)
- 肝微粒体稳定性(%Qh,人/小鼠/大鼠)
- BCRP 外排转运(MDCK-BCRP)
- P-gp 外排转运(MDCK-MDR1)
- hERG 心脏毒性抑制
研究采用 ROC AUC 分析量化每个理化参数对不同 ADME 终点的预测能力——AUC > 0.7 表示该参数具有实际区分价值。
02 核心发现一:ClogP + 分子量 = ADMET 的"双引擎"
血浆蛋白结合率(PPB)
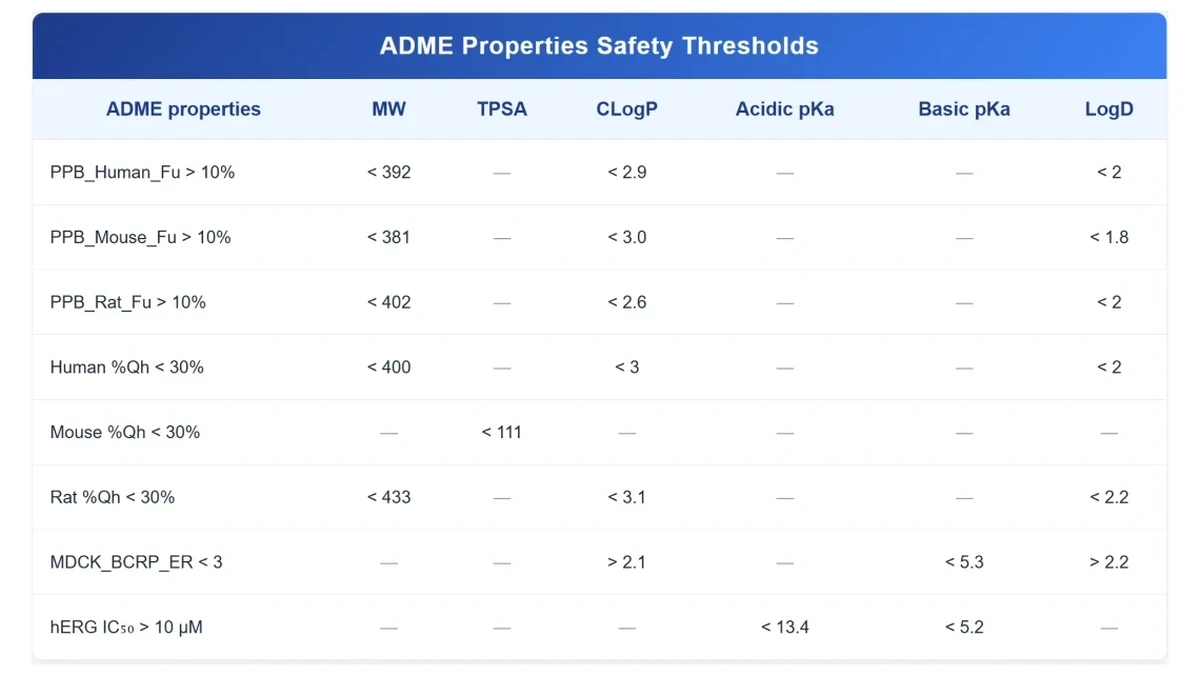
研究发现,ClogP(AUC = 0.9)和 logD(AUC = 0.9)是预测人血浆蛋白结合率最强的两个参数,分子量(AUC = 0.8)紧随其后。
- 70% 的低 PPB 化合物(fu% > 10%):ClogP < 2.9
- 仅 6% 的高 PPB 化合物(fu% < 1%)满足此条件
- 分子量阈值:MW < 392 可区分 70% 的低结合 vs 16% 的高结合
- >90% 低 PPB 化合物同时满足 ClogP < 2.9 + MW < 392
实例验证:双氯芬酸(ClogP = 4.58)fu% < 2%,而吗啡(ClogP = 0.04)fu% 高达 62%。亲脂性每上升一个单位,蛋白结合的"紧箍咒"就紧一圈。
肝微粒体稳定性
对于人肝微粒体,ClogP(AUC = 0.8)和分子量(AUC = 0.8)同样是核心影响因素。>70% 的高稳定性化合物(%Qh < 30%)满足 ClogP < 3 和 MW < 400。
跨物种差异警示:ClogP 和 MW 对小鼠肝微粒体稳定性的 AUC 仅 0.5——几乎等同于随机猜测。这提示我们:动物模型中的代谢数据不能简单外推至人体,早期预测工具需要具备跨物种对比能力。
03 核心发现二:pKa 和 logD——外排与毒性的"开关"
BCRP 外排转运
碱性 pKa 和 logD(AUC = 0.8)被鉴定为 BCRP 底物识别的关键参数。化合物亲脂性越高(logD > 2.2)、碱性越弱(碱性 pKa < 5.3),越不容易被外排。
- 降低 BCRP 外排风险:logD > 2.2 + 碱性 pKa < 5.3
- 72% 的 logD > 2.2 化合物不是 BCRP 底物,仅 27% 是
- 70% 的碱性 pKa < 5.3 化合物不是 BCRP 底物,仅 25% 是
对于 P-gp,研究坦诚指出:单一理化参数无法有效区分底物与非底物(所有 AUC 均 ≤ 0.6),此时需要借助机器学习模型或基于结构的方法。
hERG 心脏毒性
hERG 抑制是导致药物撤市的"头号杀手"。研究发现:酸性 pKa(AUC = 0.7)和碱性 pKa(AUC = 0.7)是区分抑制剂与非抑制剂的关键。
- 70% 的非抑制剂:酸性 pKa < 13.4(仅 27% 抑制剂满足)
- 52% 的非抑制剂:碱性 pKa < 5.2(仅 10% 抑制剂满足)
- 化合物的质子化状态是 hERG 抑制的核心决定因素
04 一张表说清楚:ADMET 优化的理化参数"体检表"
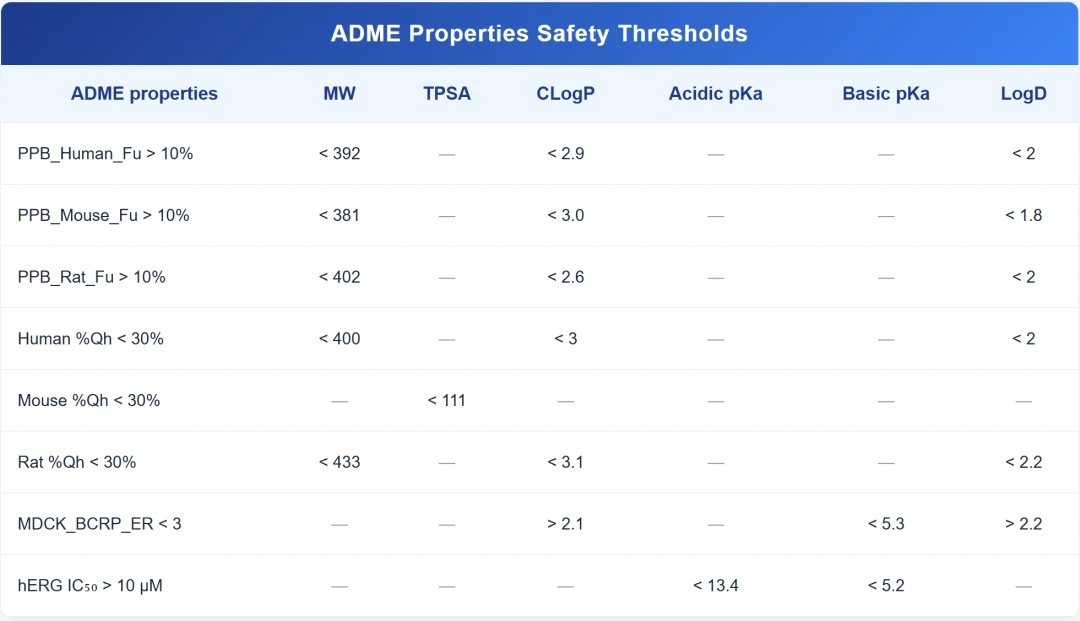
一句话总结:MW < 400 + ClogP < 3 + 碱性 pKa < 5.2 + 酸性 pKa < 13.4——你的化合物大概率拥有良好的口服生物利用度和低 hERG 风险。
05 从"事后验证"到"事前预测"
Ma et al. 的研究清楚地表明:pKa、logD、ClogP、分子量这些理化参数不是可有可无的"锦上添花",而是决定化合物 ADMET 命运的"硬指标"。
但问题来了——实验室不可能对每个化合物都测定全套理化参数和体外 ADME。那么,如何在合成之前就知道一个化合物的理化性质?如何用计算预测替代实验筛选,快速判断化合物是否落在"安全区"?
这正是 PhysChem Suite 的设计初衷。
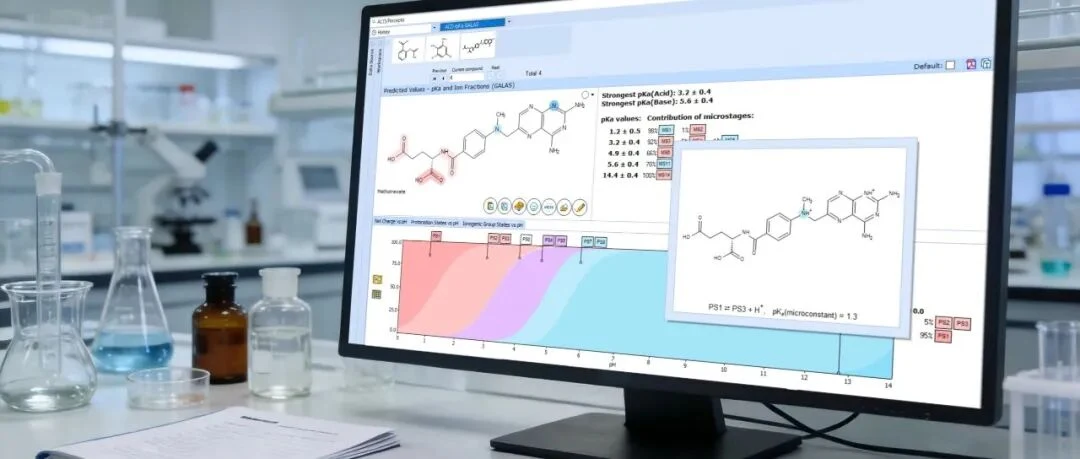
- pKa 预测——基于 25 年算法积累,训练集覆盖数万化合物。2024 版训练数据再增长 13%,配合智能归一化技术,精确预测每个可电离基团的微观 pKa 值。正如论文所示,这直接决定了化合物是否有 hERG 风险。
- logD / logP 预测——支持 pH 1–14 范围的 logD 曲线模拟,智能归一化技术确保计算偏差小于 0.01 单位。从血浆蛋白结合到肝微粒体代谢,亲脂性贯穿 ADMET 全流程。
- 综合 ADME 预测——PhysChem Suite 可与 Percepta 平台的 ADME Suite、Tox Suite 无缝联动,构建从理化性质到药代行为再到毒性风险的完整预测链条。P-gp 外排这类单一参数搞不定的复杂问题,交给 GALAS 机器学习模型。
- 合规报告——v2024 新增 QPRF 报告格式,满足 ICH M7(R2) 监管指南要求,让计算预测结果直接服务于注册申报。
06 实战场景:如何用理化参数指导化合物设计
论文的价值不仅在于数据,还在于其提供的累计分布曲线(Cumulative Plot)可视化方法。结合 Percepta 软件,可以把这种策略日常化:
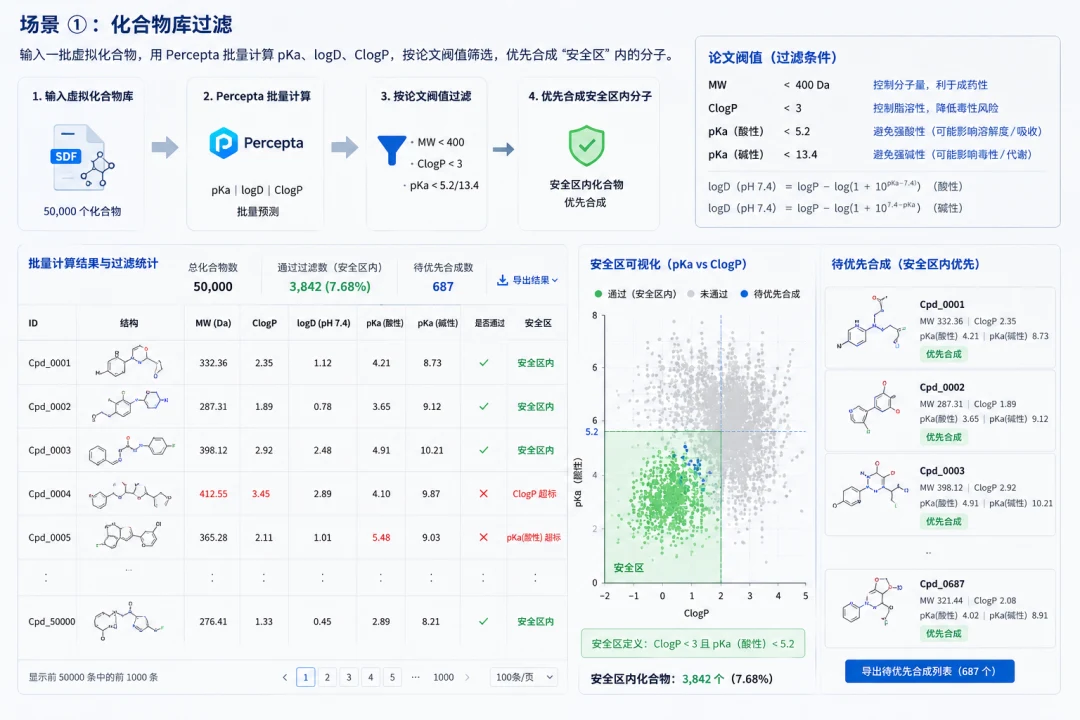
场景①:化合物库过滤
输入一批虚拟化合物,用 Percepta 批量计算 pKa、logD、ClogP,按论文阈值(MW < 400、ClogP < 3、碱性 pKa < 5.2 / 酸性 pKa < 13.4)筛选,优先合成"安全区"内的分子。
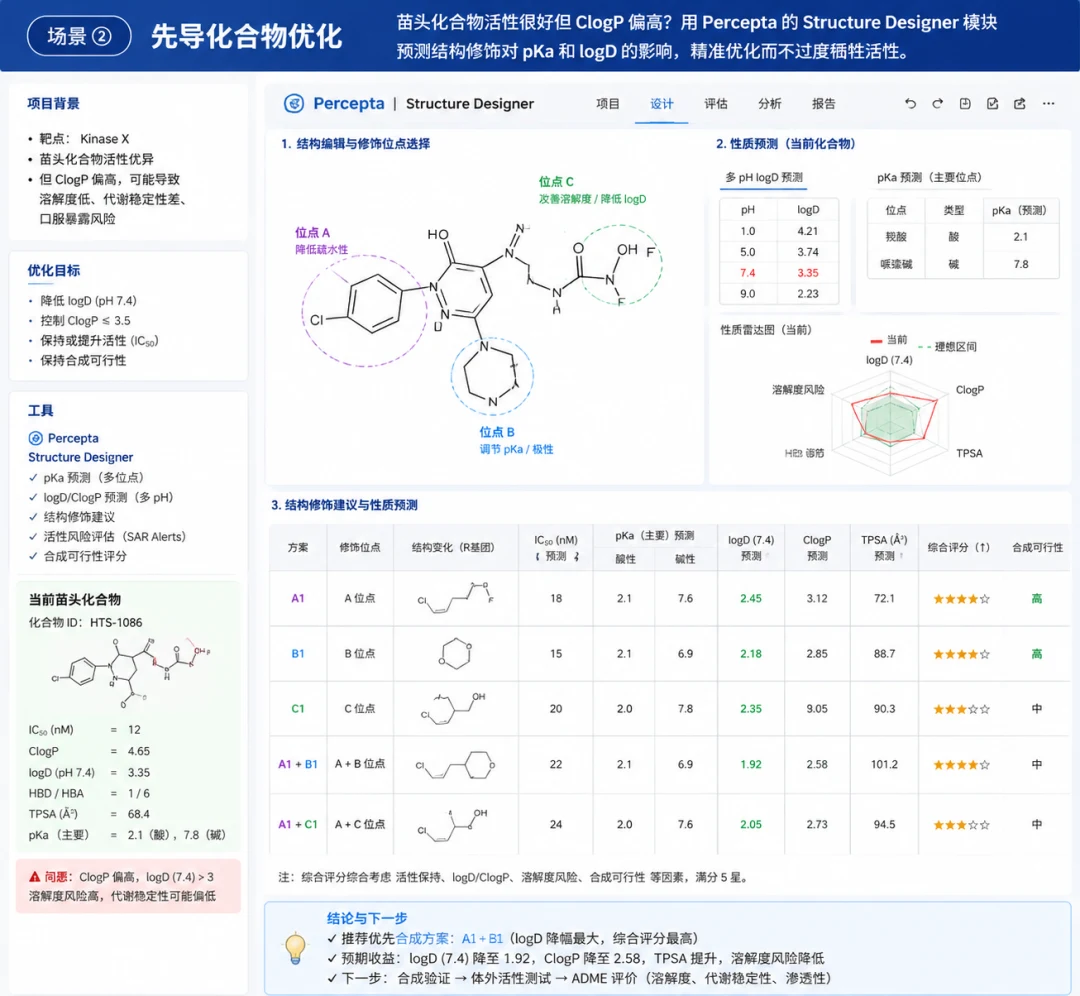
场景②:先导化合物优化
苗头化合物活性很好但 ClogP 偏高?用 Structure Designer 模块预测结构修饰对 pKa 和 logD 的影响,精准优化而不过度牺牲活性。
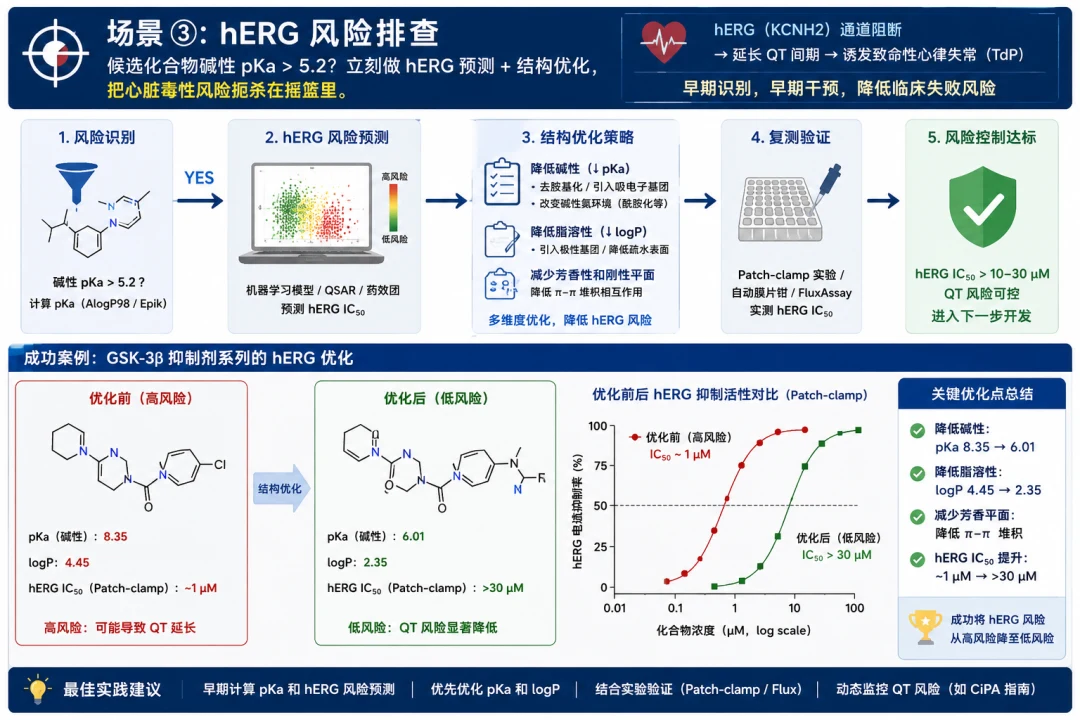
场景③:hERG 风险排查
候选化合物碱性 pKa > 5.2?立刻做 hERG 预测 + 结构优化,把心脏毒性风险扼杀在摇篮里。已有成功案例:GSK-3β 抑制剂系列通过降低 pKa + logP,hERG IC50 从约 1 μM 提升至 >30 μM。
写在最后
这篇来自 Biogen 的研究告诉我们一个朴素但重要的道理:药物研发中,"好"的化合物不仅要活性强,还要理化参数"对"。pKa、logD、ClogP 和分子量,这四个看似基础的参数,构成了决定化合物 ADMET 命运的"四象限"。
幸运的是,我们不需要像论文中那样用 ChemAxon + Biobyte + OpenEye 三家软件拼凑计算——Percepta 一个平台就能完成从 pKa 到 ADME 的全链条预测。你的化合物在"安全区"吗?不如先用 Percepta 算一算。
如需了解 PhysChem Suite 及 Percepta 成药性预测平台的更多信息,欢迎联系我们。