
3.1 挑战任务1
摘要
本章可作为基于Structure Elucidator 进行结构解析实践方法的入门指南。为此,我们采用了M. Reichenbächer 和J. Popp 所著教材《Challenges in Molecular Structure Determination》(Springer, 2012)中的22 个相对简单的结构解析任务作为示例,涵盖了基于1D 和2D NMR、MS、IR 和UV 光谱的结构解析。读者有机会将教材中详细解释的手动解析方法与使用Structure Elucidator 获得的结果进行比较。手动解析的详细描述可在Springer 服务器上获取(https://extras.springer.com/2012/978-3-642-24389-9)。
读者可免费获取Structure Elucidator 教学版(https://www.acdlabs.com/TeachingSE),利用预置的标准化电子光谱数据,完整复现前文所述的计算机辅助结构解析(CASE)全流程。通过动态调整结构约束条件与解析公理,读者能够直观观察不同假设条件下对解析结果的影响,培养应对复杂结构难题的适应性思维。我们相信,通过本章的学习并解决所有挑战任务,读者将掌握解决第4 章和第5 章中复杂实际问题的必要知识和技能。
本章所述问题均以Structure Elucidator 格式(.gnr)存储于“Challenges_Chapter_3”文件夹中(详见www.acdlabs.com/TeachingSE)。每个文件在PM 窗口中包含“未知物”的分子式,并集成了用于问题解决的光谱数据电子表格。部分挑战任务还保存了分子连接图(User MCD 窗口)、候选分子(PM 窗口)以及输出文件中的结构(Mol 窗口),以便用户熟悉程序界面。所有挑战任务均在F1 和F2 维度的公差值(tol)设置为0.005 ppm 的条件下解决,其中tol 值显示在Spectrum Parameters 对话框的“User Defined Tolerance”选项中。用户可通过调整此参数探究其对MCD 属性及问题解决方案的影响。
安装Structure Elucidator 教学版本后,用户可通过将相应文件拖拽至主程序窗口或使用File\Open 命令将挑战任务的文件加载到程序中。同时,ACD\ChemSketch[3]——Structure Elucidator 的集成化学结构编辑器——也将自动安装。除提供化学结构的创建和处理工具外,ChemSketch 还支持通过PubChem[4]、ChemSpider[5]和eMolecules[6]等丰富的在线化学信息资源检索绘制的结构。此外,ChemSketch 窗口右下角的Properties 命令还可预测分析分子的部分理化参数。
借助这些辅助工具,用户将有机会重复本章所述问题解决的所有步骤。所有对话框均配有Help 按钮,可在需要时提供操作指引。当前教学版本的主要局限在于,给定问题的电子表格中的光谱数据无法编辑,但可以从初始数据创建的MCD 中自由编辑数据。因此,读者可以提出自己的公理,将其引入MCD,并检查新公理如何影响问题的解决方案。我们希望通过此类计算实验,读者能够更全面地理解CASE 方法的本质并认识其优势。
若用户在书籍的辅助下解决若干问题后,认为自己已准备好全面测试计算机辅助结构解析的经验,则可在阅读本章相应部分之前开始解决后续问题。需要注意的是,程序教学版本的某些菜单和对话框与第二章所述完整版本略有不同。但我们认为这些差异并不显著,不会造成任何混淆。
正如前文所强调的,计算机辅助结构解析(CASE)技术的应用并不意味着化学家可以忽视分子光谱手动解析技能的培养。事实上,光谱学家的经验越丰富,其在计算机辅助结构解析中的效率和成功率就越高。这是因为所有输入程序的数据都必须由研究者仔细检查和编辑(如有必要),以确保充分利用所有明确的信息,并避免在数据集中引入错误的公理。
计算机推理方法与人类专家的思维方式存在本质差异。我们相信,通过结合使用Structure Elucidator 与教材中详细描述的人工解析方法,读者能够深刻体会到这种差异。同时,我们确信,在本章中独立解决简单的“教学”问题并使用Structure Elucidator 的过程中,读者将逐步培养出将计算机辅助方法应用于复杂实际问题的能力,这些复杂问题将在第三部分中呈现。值得一提的是,这些高阶案例聚焦2011-2013 年间新发现的天然产物结构鉴定,其光谱数据均选自标注为“结构新颖”或“独特构型”的权威研究论文,具有鲜明的学术前沿性与挑战性。
“未知物”的结构如下:
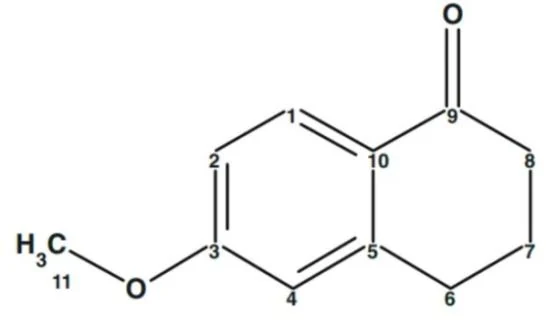
分子结构解析的第一步是确定未知物的分子式。通过分析教材[1]中提供的质谱(MS)数据,可以明确分子离子峰位于m/z = 176 amu。由于M+为偶数,表明该分子可能不含有氮原子,或者含有偶数个氮原子(nN = 0、2、4 等)。红外(IR)光谱未能明确指示氮原子的存在与否:1,673 cm⁻¹处的吸收峰可能源于共轭酮或叔酰胺(在3,000 cm⁻¹以上区域未观察到NH 或OH 的特征吸收峰),同时未发现腈基(2,200–2,600 cm⁻¹)的相关信号。IR 光谱中1,594 cm⁻¹和1,497 cm⁻¹处的吸收峰提示分子中可能存在苯环,这一点通过质谱中m/z 91 amu的特征峰得到进一步验证。
¹³C NMR 光谱包含11 个信号,表明分子中至少含有11 个碳原子。¹H NMR 谱的积分值以及¹³C DEPT 135 模式显示,分子中至少含有12 个氢原子。质谱中未观察到与Cl、Br 和F相关的同位素峰(未出现Δm = 19 或20 的峰,¹³C 谱中未出现多重峰)。M+2 峰的相对强度低于4.4%,排除了硫原子存在的可能性。IR 光谱中1,673 cm⁻¹处的C=O 吸收峰以及¹³C NMR中54.9 ppm 处的CH₃单峰(特征性O–CH₃信号)表明分子中至少含有两个氧原子。
我们推断该分子可能属于CHNO 类化合物。基于现有信息,我们可以利用Structure Elucidator 中的“Edit Spectrum Query\Generate MF…”命令(图3.1)推断未知物的可能分子式。
图3.2 展示了分子式生成器窗口,其中列出了生成分子式的选项和参数。在窗口的左上角,显示了允许的化学元素数量范围。考虑到¹³C NMR 谱中信号强度较低,可能有1 或2个季碳原子未被检测到,因此碳原子数范围设定为C(11–13)。一般情况下,1 或2 个氢原子的信号可能因溶剂吸收峰干扰或属于活泼氢而未被观测到。在当前问题中,¹H NMR 谱和IR 光谱均未出现溶剂峰,且无证据表明存在可交换氢,但为了说明原理,氢原子数范围仍设定为H(12–14)。尽管氧原子的最小数量为2,但程序中允许氮原子数范围为N(0–6),氧原子数范围为O(0–10)。
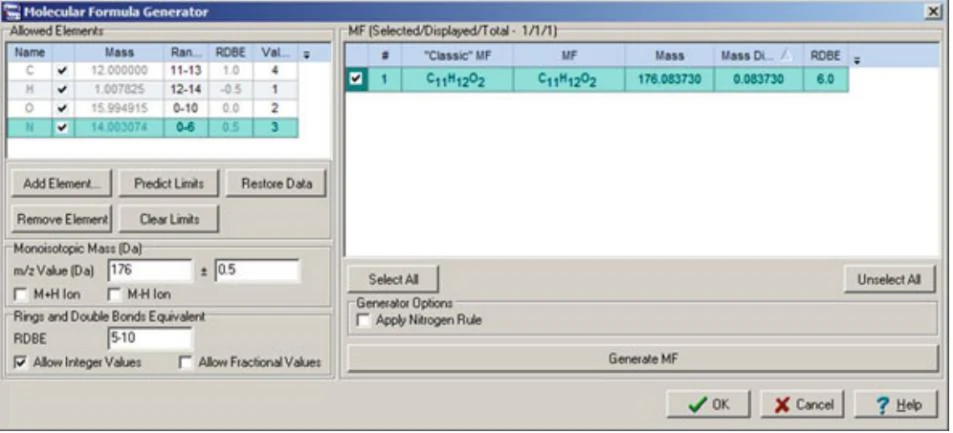
在解决实际问题时,通常需要精确测量分子离子质量值,并将其与所有候选分子式的计算值进行比较。对于结构1,其计算分子离子质量(�����+)为176.083725 amu。由于“未知物”的标准分子质量为176 amu,因此将质量容差设定为±0.5 amu。基于分子中可能含有羰基和苯环的推断,不饱和度的范围设定为5–10。
当执行“Generate MF”命令(图3.2)后,程序在右上角生成了一个唯一的分子式C11H12O2。用户可以通过点击“OK”将选定的分子式输入程序中。因此,传统的分子式逻辑推断(如教材[1]所述)被程序的计算组合所取代。
若采用传统分子结构解析方法(如教材[1]第5.4.1 章节所述),后续步骤将基于结构假说的系统化推导,通过整合所有可用光谱数据进行交叉验证,逐步锁定候选分子结构单元。而在使用Structure Elucidator 进行结构解析时,数据处理的下一步重点在于对可用1D 和2D NMR 谱图中信号的峰提取。虽然这一过程可由程序自动完成,但为了避免引入错误的“公理”,最佳方式是以交互模式进行人工标峰[3]。最终生成的光谱数据表需要用户仔细检查,并在必要时进行修正。表3.1 展示了从13C、1H、HSQC 和HMBC 数据中提取的谱图-结构信息。
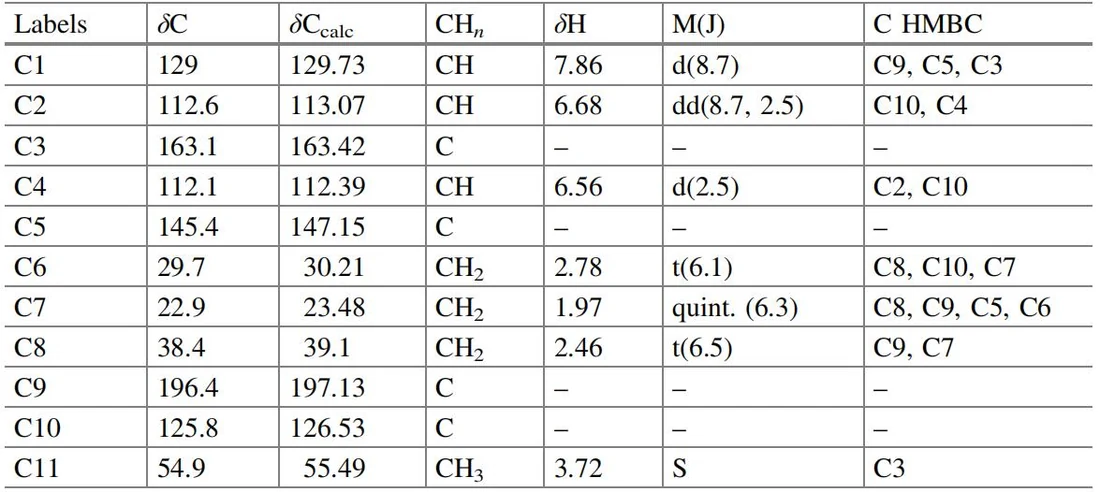
实际上,表3.1 是在程序完成问题求解后自动生成的(即当带有¹H 和¹³C 化学位移归属信息的优选结构被确定为最佳解决方案时)。因此,该表包含一列δCcalc,其中显示了基于HOSE 算法计算的¹³C 化学位移,便于与实验值进行系统对比。M(J)列则汇总了从1D 和2D NMR 谱图中提取的裂分类型和JHH 耦合常数(以Hz 为单位)。表3.1 的设计旨在以符合学术出版物标准的格式呈现初始光谱数据。
用于解析问题的NMR 谱图列表显示在“Edit Spectrum Query”窗口的左上角(图3.3)。图3.4 展示了挑战任务1 的HSQC 和HMBC 谱图,这些谱图在对话框中的可视化形式为结构解析提供了直观支持。
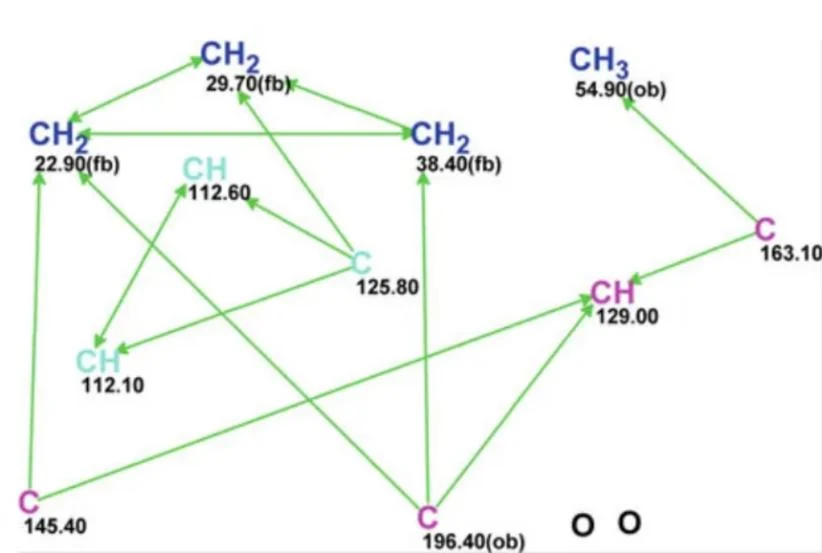
表3.1 和图3.4 中的数据被用于构建图3.5 所示的分子连接图(MCD,参见第2.1.3 节)。为此,用户需执行以下命令:Structure Elucidation\Create Molecular Connectivity Diagram(MCD)…。图3.5 展示了结构单元C、CH、CH2、CH3 及其对应的化学位移和原子属性,同时标注了分子式中的杂原子。碳原子通过特定颜色标记其杂化状态:蓝色—sp³,紫色—sp²,浅蓝色—非sp(sp²或sp³)。标签“fb”表示碳原子与杂原子的连接被禁止,而标签“ob”则表示与杂原子的连接是必需的。这些标签由程序基于原子属性相关表(Atom Property Correlation Table,参见第1.3.2.4 节)自动分配。此外,碳原子之间的绿色箭头直观映射了相应的HMBC 连接关系。
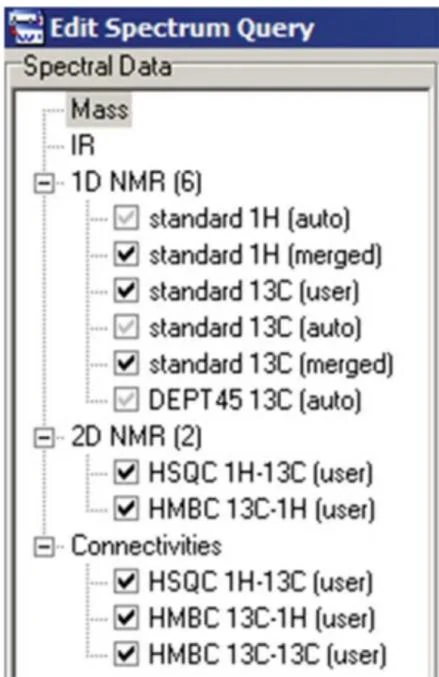
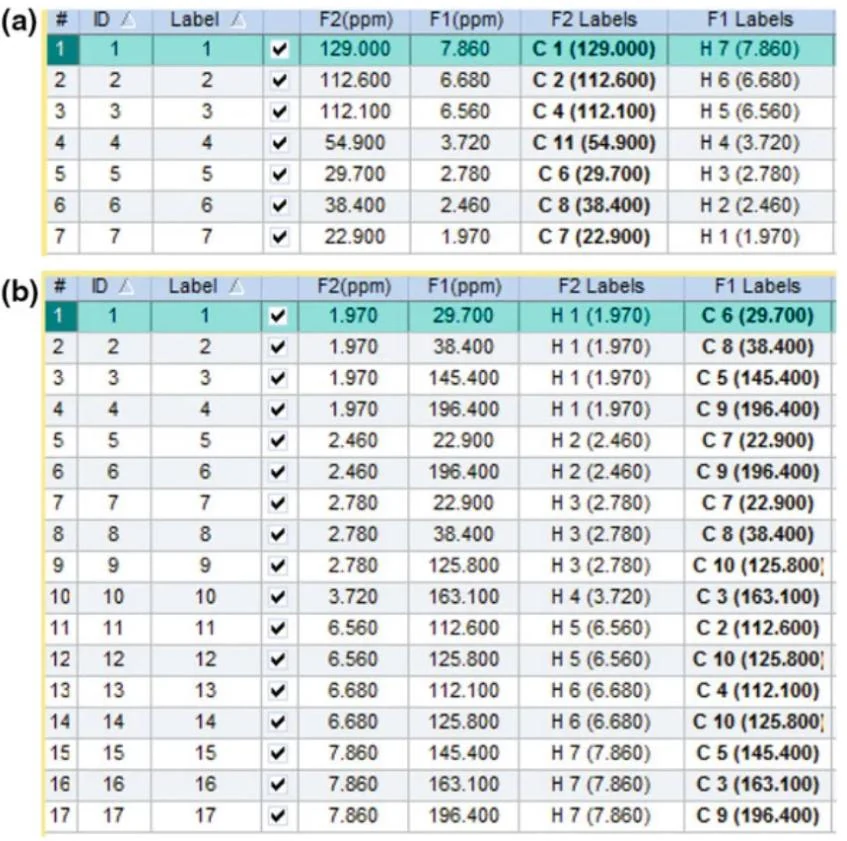
图3.5 显示,除三个碳原子(C 112.10、C 112.6 和125.8,浅蓝色标记)外,程序已明确确定了所有碳原子的杂化状态。这三个原子被标记为“模糊”杂化状态(非sp),这是因为算法考虑了分子中含有两个氧原子的事实。根据谱图-结构相关性分析,每个浅蓝色碳原子可能属于O–C–O 片段(sp³杂化)或与杂原子隔离的碳碳双键(C=C,sp²杂化)。
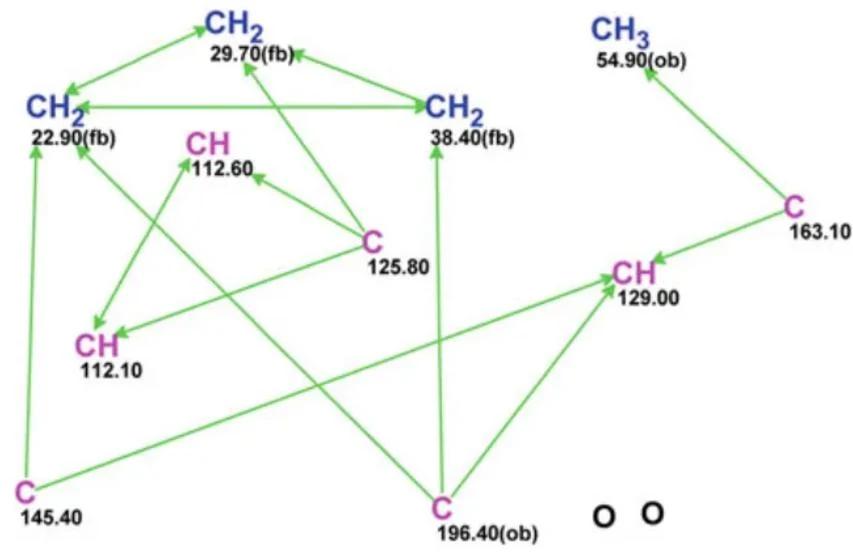
在分子连接图(MCD)创建完成后,研究者需对其进行全面审查。Structure Elucidator提供了便捷的工具,使研究者能够基于光谱数据的初步分析结果和可靠的附加信息对MCD进行编辑。在当前案例中,C=O 和O–CH3 基团的存在是明确的(C 196.4 和C 54.9 自动标记为“ob”),因此O–C–O 片段的形成是不可能的,浅蓝色碳原子应被指定为sp²杂化(通过点击“Edit Atom Properties”图标并选择相应原子进行编辑)。经过编辑后的MCD 如图3.6所示。
对MCD进行检查(通过命令Structure Elucidation\Check MCDs…)后,结果显示HMBC数据中不存在矛盾(MCD 通过了矛盾检查)。因此,启动了严格结构生成(通过命令Structure Elucidation\Run SCB Generator…),并使用了常见的SCB 生成器选项(参见图2.6 和图2.10)。
结构生成完成后,结果如下:共生成26 个分子,经过过滤后保留了20 个分子,生成时间为0.014 秒。随后,使用增量法进行¹³C 化学位移预测(通过命令Tools\Calculate\CNMR Spectrum\Increments),并移除重复结构(通过命令Tools\Remove Duplicated Structures)。最终,获得了10 个非重复的候选结构。我们将结构生成结果总结为以下简洁形式:k = 26 →20 →10,tg = 0.014 秒。这一形式将作为本书中总结问题解决结果的模板。
根据CASE 通用策略(参见第2.2.1 节),输出文件按平均偏差升序排序后,分别采用神经网络和HOSE 算法进行¹³C 化学位移预测(通过命令Tool\Calculate\CNMR (Neural Net)或Tool\Calculate\All Spectra…)。随后,基于HOSE 算法计算的¹³C 化学位移平均偏差dA对结构进行重新排序。为便于分析结果,结构以结构列表形式显示(点击“Structure List”图标)。要查看不同方法对不同核计算的平均偏差,需将光标置于结构列表字段上,并在上下文菜单中选择命令Select Data…。
当排序后的输出文件准备好供用户审阅时,建议生成一份适合打印的ChemSketch 文档。为此,需执行以下命令:File\Create Report\List of Structures…。在Create Report 选项中,需输入要包含在报告中的结构数量(本例为1–8 条记录)。
通过上述流程,获得了包含八个项目的结构列表,如图3.7 所示。
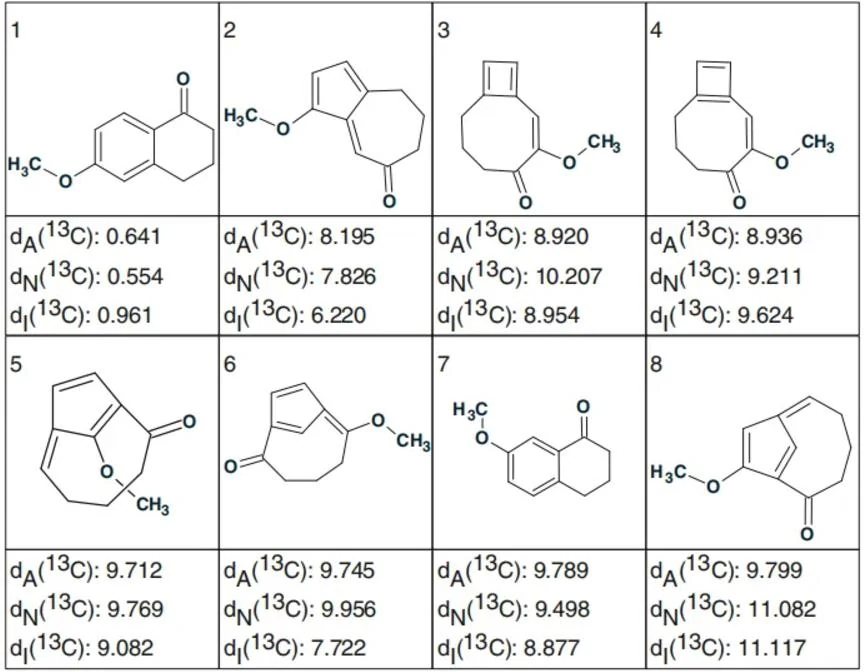
图中标注了以下平均偏差:dA(基于HOSE 算法计算的偏差)、dN(基于神经网络计算的偏差)和dI(基于增量法计算的偏差)。
图3.7 显示,所有三种¹³C 化学位移预测方法均将第一个结构(#1)选为最可能的结构。结构#2 与#1 的偏差差异非常大(Δ = d(2) −d(1) = 5–7 ppm),这为结构的正确性提供了可靠证据。若点击工具栏上带有黄色标记的“¹³C”图标,可以直观展示所选结构的优先级。该命令根据实验值与计算值的差异,以不同颜色标记碳原子:若d ≤3 ppm,标记为绿色;d ≤15 ppm,标记为黄色;d ≥15 ppm,标记为红色。
图3.8 展示了排序后的输出文件结构,其中原子上标注了相应的颜色圆圈及最大偏差值。
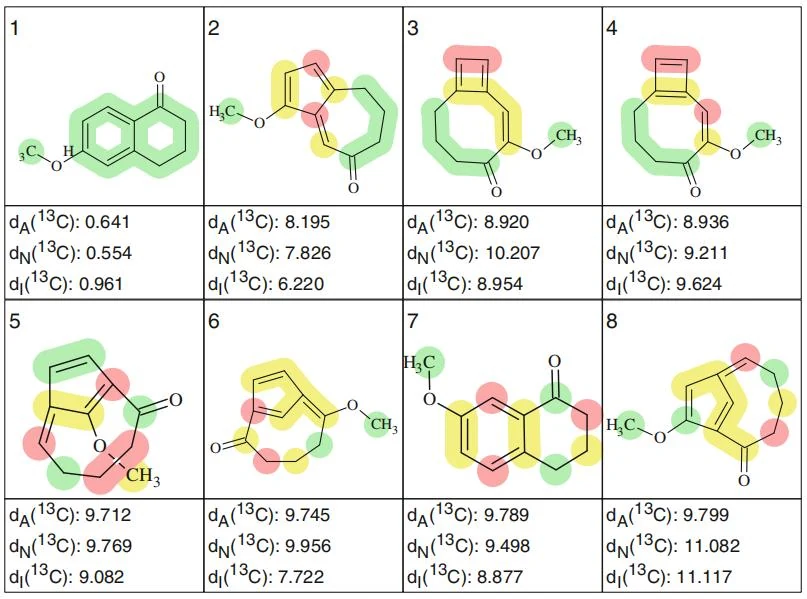
d ≤3 ppm—绿色,d ≤15 ppm—黄色,d ≥15 ppm—红色。
图3.8 清晰地展示了结构#1 的合理性(所有碳原子均以绿色高亮显示)。值得注意的是,结构#1 的最相似异构体(教材[1, 2]中讨论的竞争结构5.2)具有巨大的偏差,在排序过程中被置于第七位。
在第一次结构生成过程中,并未使用表3.1 中的所有光谱信息。表3.1 中的M(J)列包含了通过1H NMR 测定的信号多重性及相应的耦合常数。多重性值指示了给定碳原子邻近环境中连接的其他碳原子上的氢原子总数n(H),其关系为n(H) = (M −1)。例如,若多重性M= 1(单峰),则n(H) = 0;若M = 2(双峰),则n(H) = 1,以此类推。这些信息可作为结构生成过程中的附加约束条件。要引入n(H)值,需在MCD窗口中激活工具栏上的“Edit Atom Properties”图标,并在“Number of Hydrogens on Neighbor Atoms”字段中输入相应数值。
利用氢原子数量信息进行重复结构生成后,结果如下:k = 2 →1,tg = 0.004 秒。因此,¹H 信号多重性携带的附加结构信息生成了单一结构,且生成时间缩短了四倍。
为了验证系统在不同信息条件的影响,我们基于初始分子连接图(图3.5)重新进行了结构生成,未引入任何人工修正。结果显示:候选结构数量变化为k = 26 →20 →10,生成时间tg = 0.070 秒。虽然生成的结构与图3.7 和图3.8 所示结果一致,但此场景下的运算时间延长至原先的五倍。尽管在毫秒级时间尺度上这种差异微乎其微,但对于需要长时间运算的复杂问题,效率差异将变得尤为显著。最终解析出的结构3.2 及其对应的13C 化学位移归属如下图所示。
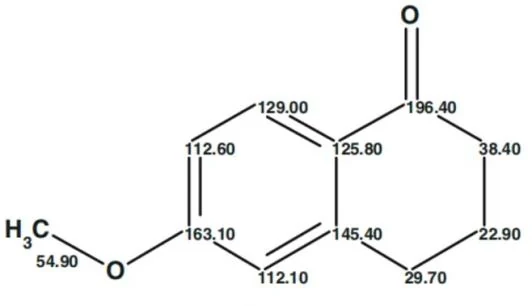
由此可见,传统方法需要耗费大量时间和智力才能解决的结构解析问题,借助StrucEluc专家系统得以快速、可靠且明确地解决。
由于目标分子结构较小,我们采用传统生成器计算了分子式C₁₁H₁₂O₂对应的异构体总数N = 555,173,961。而实际生成的候选结构数量k = 10,据此可通过公式μ = (1 −log k/log N) 计算得出结构信息提取度μ = 0.88(参见第1.1.1 节)。这表明,通过13C 化学位移预测提取的结构信息占剩余比重μ(¹³Ccalc) = 0.12。值得注意的是,当引入1H 信号裂分类型(如单峰、双峰等)信息后,系统直接生成了唯一正确的结构,说明1H 裂分模式所携带的结构信息占比同样达到0.12。这种通过峰型特征提取隐含结构信息的能力,体现了StrucEluc 系统对NMR数据的深度解析效能。