
从 DP5q 到 CASE:AI 加速 NMR 结构确证的完整解决方案
核心看点:
剑桥大学 Goodman 团队最新发表在 Chemical Science 上的工作提出 DP5q——用图卷积神经网络(GCNN)+ 分位数回归替代 DFT 计算,显著缩短了NMR结构确证的计算时间,实现数个数量级的加速。
这项工作与 ACD/Labs 的 CASE(计算机辅助结构解析)专家系统形成天然的互补关系:DP5q 擅长"快速确证候选结构",而 CASE 擅长"从零生成并验证所有可能的结构"。两者结合,构成了 AI 时代 NMR 结构解析的完整解决方案。
1|NMR结构确证的困境
核磁共振波谱(NMR)是小分子表征的核心技术。当一个新化合物被合成或分离后,如果没有参考谱图可供比对,结构确认就变得异常困难。这导致了许多后来被纠正的错误指认案例——据不完全统计,天然产物领域已报道超过1000例结构修正。
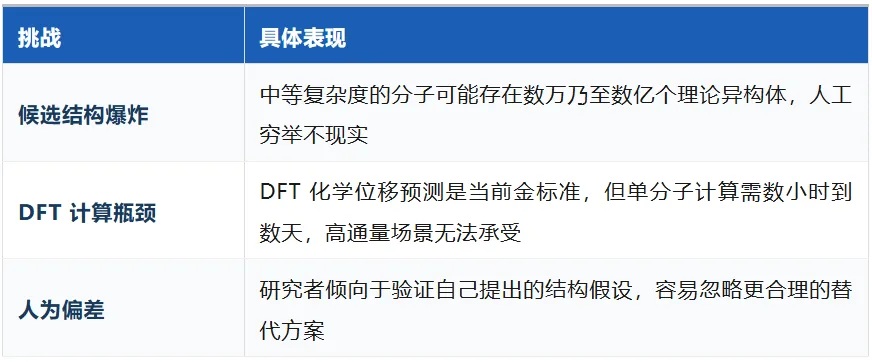
传统的人工 NMR 解析流程面临三大挑战:
2|DP5q:用GCNN把DFT"踢出局"
2.1 从DP4到DP5再到DP5q
Goodman 团队在 NMR 辅助结构解析领域深耕多年:
DP4 方法(2010):基于 DFT 预测位移与实验位移的误差分布,从候选列表中选择最佳匹配结构。局限性在于必须假设正确结构已在列表中。
DP5 方法(2024):更进一步,构建了包含数万个原子环境表示及其 DFT 误差的数据集,对每个候选结构单独计算绝对概率置信度。但仍然依赖昂贵的 DFT 计算。
DP5q 方法(本文):使用图卷积神经网络(GCNN)+ 分位数回归直接预测化学位移的概率分布,完全消除对DFT计算的依赖。
2.2 核心创新:分位数回归的不确定性校准
与以往方法不同,DP5q 并非只预测化学位移的单一值,而是预测完整的概率分布(第1至99百分位共99个分位数):
关键设计要点:
采用修改后的 Huber 损失函数进行分位数回归
通过单调性正则化确保预测分位数严格递增(符合累积分布函数性质)
训练数据来自 NMR Shift DB 整理后的 22,248个唯一分子
模型架构为 CASCADE 图卷积网络
为什么选分位数回归而不是正态分布?
以往方法(如 IMPRESSION)假设预测服从正态分布,需要显式拟合分布参数。分位数回归直接构建概率分布,且推理速度不随参考数据集规模增加而变慢,可任意扩展训练数据。
2.3 速度飞跃:数量级加速
这是最引人注目的结果——DP5q(基于GCNN)在保持准确度接近 DFT 级别的同时,实现了数个数量级的速度提升:
原文核心结论(Chemical Science, 2026):
"accelerating structural elucidation by several orders of magnitude by eliminating costly DFT calculations" —— 通过消除昂贵的DFT计算,将结构解析加速了几个数量级
"previously required CPU months, now can be done in seconds" —— 以前需要CPU运行数月的工作,现在可以在几秒钟内完成
DP5q 分析耗时约35分钟(含构象搜索),而传统 DP5 流程中仅 DFT 相关步骤就需要数周至数月不等
需要注意的是,上述加速幅度针对的是 DP5 分析流程本身(即从候选结构到概率评分这一步)。完整的结构解析流程还包含前置的构象搜索等步骤,这部分时间两种方法相同。
2.4 实测效果
研究团队在两类极具挑战性的测试上验证了 DP5q 的有效性:
结构修订案例(24对分子)
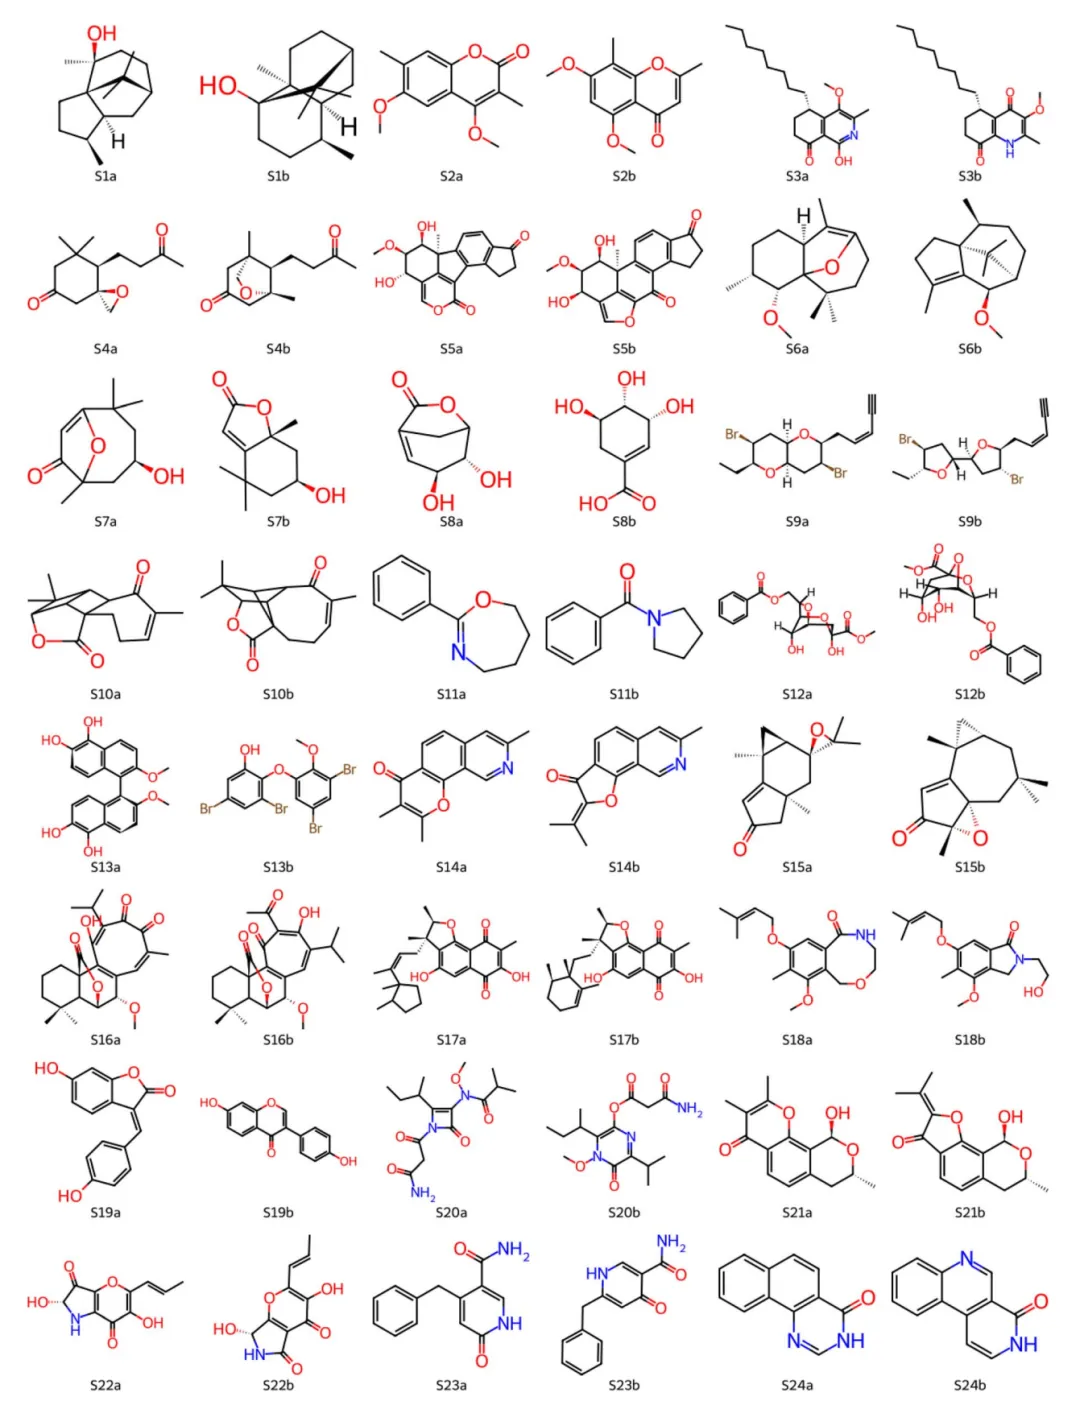
图 8. 若干分子的实例展示,这些分子的首次公开报道结构均经过后续实验与计算方法重新鉴定。其中,化合物命名中的字母 a(例如 S1a)代表最初发表的推测结构,字母 b(例如 S1b)则代表经结构确证后修正的最终结构。
选取已发表后被修正的天然产物/合成分子案例(原始提案→后续通过重新合成或X-ray确认被推翻):
使用单一构象(力场优化)时:22/24 案例的修正结构 DP5q 分数高于原始错误提案
使用 ETKDGv3 多构象优化后:24/24 全部案例中正确结构的分数均高于原始提案
唯一有挑战的是 S13(对称双萘结构 vs 非对称修正结构,NMR环境数目不同),多构象处理后也成功区分
相对立体化学解析(42个分子)
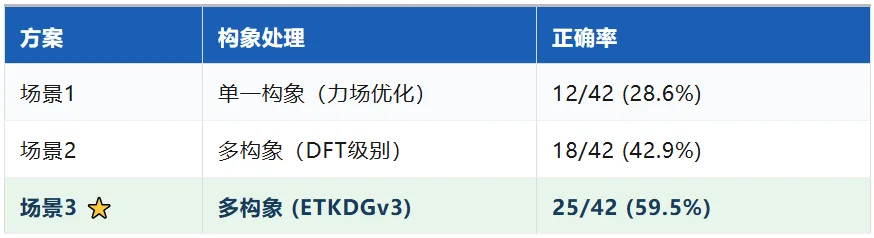
对比基准:DP4-AI 仅 15/42,DFT-DP5 仅 16/42。DP5q (ETKDG) 不仅超越了所有基于DFT的方法,还避免了所有DFT计算成本。
3
DP5q很强大,但它解决不了"候选结构从哪来"的问题
在 DP5q 的工作流程中,候选结构的来源有三种:
人工提出——研究者根据自己的化学直觉和经验,手动列出可能的异构体。这种方式高度依赖于个人经验,极易遗漏正确的结构(尤其是骨架新颖的天然产物)。
数据库检索——在 PubChem、SciFinder 等数据库中搜索已知化合物。但对全新结构无效。
CASE 系统(计算机辅助结构解析)自动生成——这是唯一能做到无偏、系统地穷举所有可能结构的方式。
这正是 ACD/Labs 的 Structure Elucidator Suite (SES) 登场的时刻。
4
ACD/SES CASE专家系统:NMR结构解析的"全能选手"
ACD/Structure Elucidator Suite (SES) 是 ACD/Labs 公司推出的计算机辅助结构解析(CASE)专家系统平台。它解决的问题正是 DP5q 的"前置环节"——如何从原始 NMR 数据出发,推导所有可能的结构候选,并进行系统性筛选。
4.1 CASE的核心工作流程
SE Core(SES的核心模块)的标准流程如下:
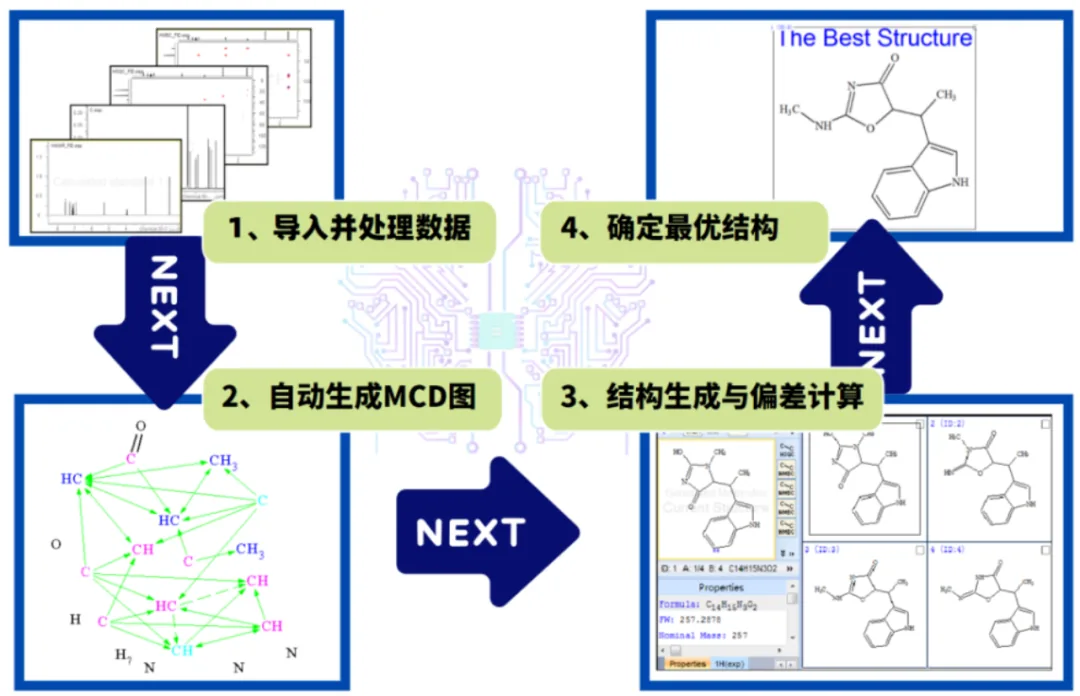
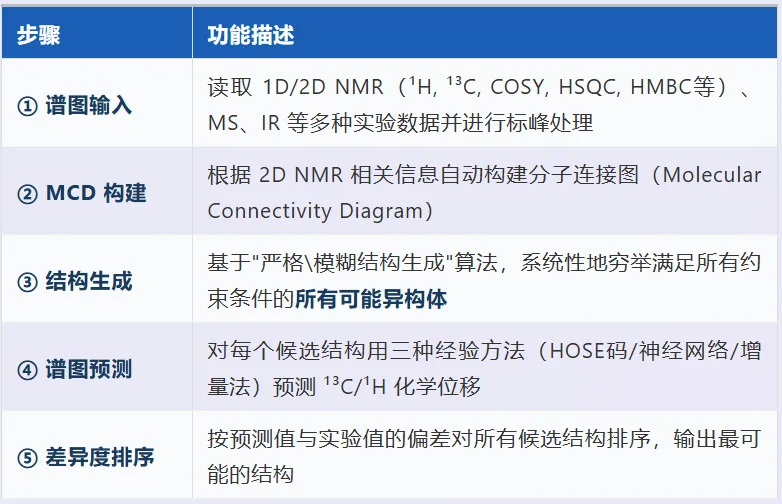
关键优势——无偏向性(Unbiased):
CASE 系统不会像人类研究者那样"偏爱"某种骨架类型。它严格按照 NMR 实验数据的逻辑约束来生成和评估候选结构,这意味着即使正确结构与直觉相悖,也能被系统公平地考虑和排名。
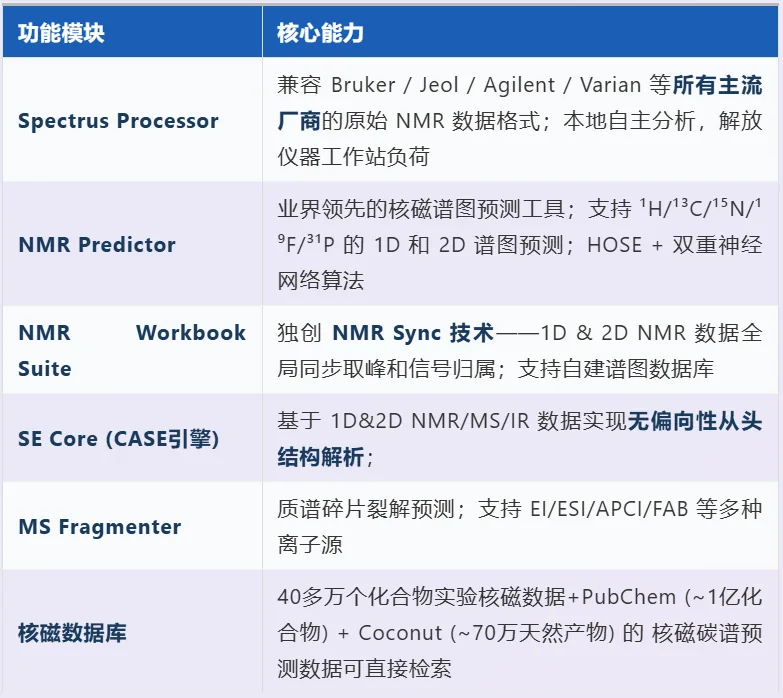
4.2 SES平台的完整能力矩阵
4.3 CASE的实际威力:几个经典案例
ACD/Labs 的 CASE 系统在大量实际应用中证明了其高效性及可靠性:
5|DP5q 与 SES CASE:互补而非竞争
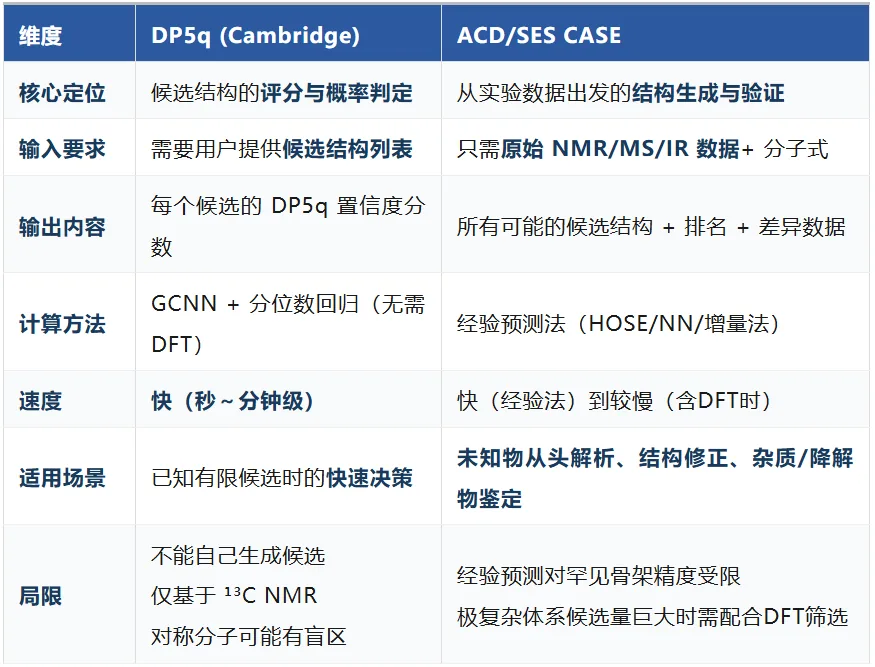
理解了 DP5q 和 CASE 各自的能力边界后,二者的互补关系就变得非常清晰:
5.1 CASE的"日常模式" vs "高难模式"
需要特别说明的是,并非所有结构解析任务都需要引入 DP5q 或 DFT。根据 ACD/Labs 在超过 400 个已发表案例中的统计,CASE 的经验预测算法(HOSE码/神经网络/增量法)在日常工作中表现如下:
日常模式——CASE 经验算法即可搞定(占绝大多数情况):
骨架常见、结构相对简单的分子 → 数据库中已有大量相似片段参考
CASE 生成候选后,正确结构的平均偏差 d_A 通常 < 3 ppm
Top-1 排名即为正确结构的概率很高,无需额外验证
典型场景:已知骨架的衍生物、常规合成中间体、大多数天然产物
高难模式——需要 CASE + DP5q/DFT 协同(少数棘手案例):
骨架极度新颖(如梯烷类 ladderane、新型杂环体系)→ 数据库中缺乏参考片段
多个候选差异度非常接近,经验算法无法自信区分排名前几的结构
缺氢/贫氢分子(H/C 重原子比 < 2),2D NMR 信息量有限
立体化学争议,非对映体之间谱图差异极小
简而言之:DFT 和 DP5q 不是 CASE 的"标配",而是面对疑难问题时的"火力支援"。
5.2 理想的协同工作流
CASE → DFT/GCNN 筛选 → 最终确认(三步走策略)
Step 1:CASE 自动生成候选(SES SE Core)输入实验 2D NMR + MS 数据 → 系统穷举所有可能结构 → 用经验预测法快速初筛 → 输出 Top-N 候选(通常 N = 1-5)
Step 2:高精度评分(DP5q 或 DFT)将 CASE 输出的 Top-N 候选送入 DP5q(秒级完成)或 DFT(小时级)进行精确化学位移预测和概率评分 → 排除假阳性
Step 3:最终确认与报告综合 CASE 的差异度数据和 DP5q/DFT 的概率分数 → 得出最终结论 → 生成标准化报告
这种协同模式已有成功先例。
Buevich & Elyashberg (J. Nat. Prod. 2016) 首次展示了 CASE + DFT 协同策略:先用 CASE 从海量异构体中筛选出少量候选(3~15000个),再对这些有限的候选执行 DFT 高精度计算。这种"粗筛+精判"的组合比纯 DFT 方案效率高出数十到数千倍——而 DP5q 正好可以把 Step 2 中的 DFT 替换为 GCNN,使整个流程进一步加速。