
药物代谢酶 P450 预测模块
研究药物在体内的代谢过程及其化学变化,对于阐述药理作用、毒性研究、结构修饰等都具有重要意义,而药物代谢的过程最重要的角色便是参与其中的各种酶,其中,细胞色素CYP450酶是临床前药物代谢研究的重要对象。细胞色素P450(cytochromeP450或简称P450)代表着一个很大的可自身氧化的亚铁血红素蛋白家族,属于单氧酶的一类。P450主要存在于肝脏微粒体中,同时也少量分布于小肠、肺、肾、脑中。涉及药物代谢的P450 主 要 为 CYP1、 CYP2、CYP3家族中5种重要的亚型:CYP3A4 (占 P450代 谢 药 物 的 50%)、CYP2D6(30%)、CYP2C9(10%) 、CYP2C19(2%)、CYP1A2(4%)。
在药物发现早期利用计算机模型预测药物可能参与的代谢,将极大节省药物研发的成本和提高药物发现的成功率。Percepta软件提供了三个与P450酶相关的预测模块,分别是:
01 P450 Substrates:
预测化合物作为P450酶(5个亚型)底物被代谢的可能性。
02 P450 Inhibitors:
预测化合物对P450酶(5个亚型)产生抑制作用的可能性。
03 P450 & HLM Regioselectivity
预测化合物被人肝微粒体或P450酶(5个亚型)介导发生代谢的可能代谢位点。
一、P450 Substrates模块介绍
功能特色:
预测化合物作为P450酶(CYP3A4, CYP2D6,CYP1A2,CYP2C9 和 CYP2C19)代谢底物的可能性;
- 对每个预测结果提供可靠性指数评分;
- 以柱状图的形式展示预测结果;
- 提供后台数据库中5个结构相似的化合物实验数据供用户参考;
支持用户添加实验数据对预测模型进行训练。
界面介绍
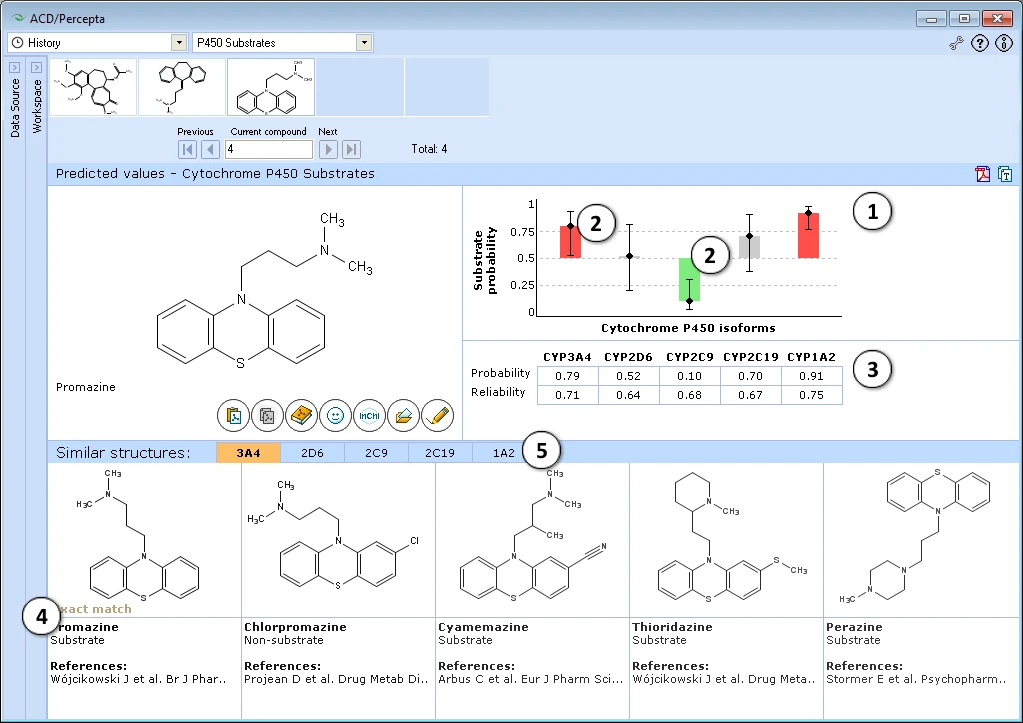
柱的高度表示测试化合物作为相应P450酶底物的概率,工字线表示预测的区间。红色条表示有把握预测的底物,绿色条表示有把握的非底物,灰色条表示不确定的预测。配色方案同时考虑了预测概率和可靠性指数值;
表格显示了每个P450酶底物的概率预测结果和可靠性指数;
显示后台5个相似结构的实验数据及参考文献来源;
点击不同的P450亚型进行切换查看相似结构实验数据。
二、P450 Inhibitors模块介绍
功能特色:
预测化合物对P450酶(CYP3A4, CYP2D6, CYP1A2, CYP2C9 和 CYP2C19)产生抑制作用的可能性,分别包括两个抑制强度的档次:“General” (IC50 < 50 μM) 或“Effective” (IC50 < 10 μM) ;
- 对每个预测结果提供可靠性指数评分;
- 以柱状图的形式展示预测结果;
- 根据实验数据对五种最相似的结构进行了分类;
支持用户添加实验数据对预测模型进行训练。
界面介绍
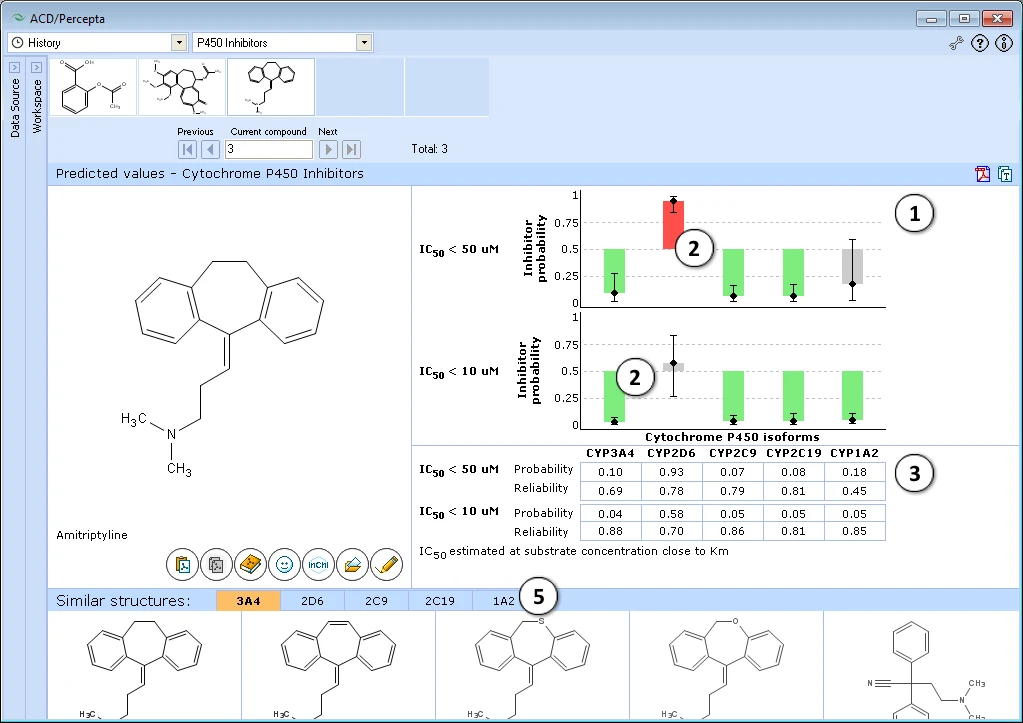
预测以柱状图的形式可视化呈现。图的上半部分对应一般抑制强度预测模型(IC50 < 50 μM),下半部分对应强抑制预测模型(IC50 < 10 μM);
柱的高度表示测试化合物作为相应P450酶底物的概率,工字线表示预测的区间。红色条表示有把握预测的底物,绿色条表示有把握的非底物,灰色条表示不确定的预测。配色方案同时考虑了预测概率和可靠性指数值;
表格显示了对每个P450酶产生抑制的概率预测结果和可靠性指数;
显示后台5个相似结构的实验数据及参考文献来源;
点击不同的P450亚型进行切换查看相似结构实验数据。
二、P450 & HLM Regioselectivity模块介绍
功能特色:
预测化合物中被P450酶(CYP3A4, CYP2D6,CYP1A2,CYP2C9 和 CYP2C19)和肝微粒体介导发生代谢的代谢位点;
- 对每个预测结果提供可靠性指数评分;
- 通过对化合物的原子进行颜色标注提示预测结果信息;
- 显示后台5个相似结构的实验结果
- 界面介绍
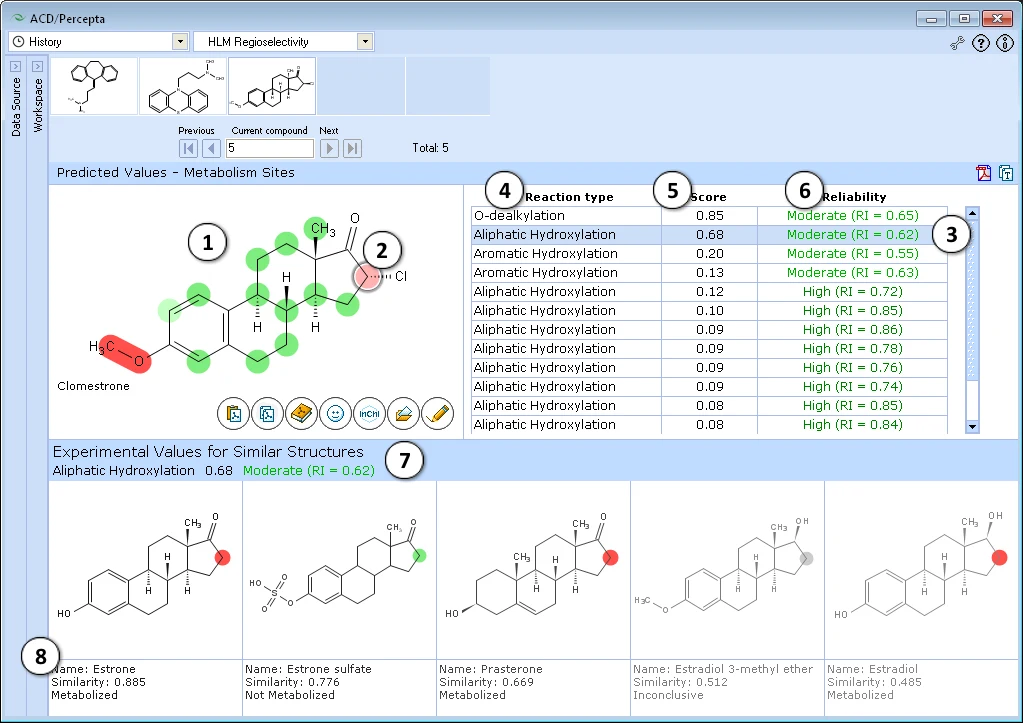
对分子中所有可能的代谢位点进行预测,并根据预测值对原子进行颜色标注(红色表示可能的代谢位点,绿色表示对代谢可能性低原子的有把握预测,灰色表示对不确定的预测)。
代谢可能性打分最高的原子会自动选择并用圆圈标识。用户可点击选择其他原子或者通过右方的表格进行选择查看结果;
- 与当前所选原子对应的表项将突出显示;
- 显示发生代谢反应的类型;
- 该原子发生代谢的可能性预测打分值;
- 对应预测结果的可靠性评分;
- 对当前选定的原子在相似结构窗扣顶部会列出预测结果;
从训练集显示五个最相似的化合物,以及实验数据,相似指数。相似化合物对应的代谢位点根据实验数据进行颜色标记(红色-实验确定的代谢位点,绿色-没有观察到代谢,灰色-不确定的数据)。
关于P450相关预测模型的信息:
实验数据来源:
04 P450 Metabolism(底物特异性和代谢位点):
只有来自科学出版物的实验数据用于细胞色素P450代谢位点的建模,使用已上市药物的代谢信息对文献数据集进行扩展,并用于细胞色素P450底物建模。我们考虑了两种主要的检测类型:
重组人细胞色素P450酶代谢实验
分析特定P450亚型的人肝微粒体(HLM)代谢,通过该亚型的特定抑制剂的代谢抑制证据进行评估。
P450 Inhibition:
收集了来源于科学出版物的基于HLM/重组酶检测的抑制剂特异性数据,重点关注被测化合物对标准探针底物代谢的抑制数据。此外,已上市药物的信息,以及NCBI PubChem项目的HTS检测数据也被采用。
数据集
用于建立底物和抑制剂特异性预测模型的数据集的大小如下表所示:
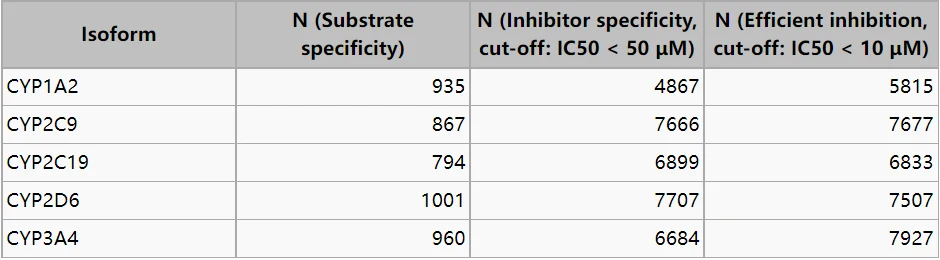
代谢位点预测模型是基于873种化合物的实验数据进行构建,这些数据来自出版物报道,包括人肝微粒体或重组细胞色素P450酶孵育后观察到的代谢物分析鉴定结果。如果观察到原子发生羟基化,则将每个至少有一个氢连接的碳原子标记为代谢位点,否则标记为无代谢位点。对于脱烷基反应,离去基团的碳原子以同样的方式标记。一些研究位点被标记为“不确定”,因此未用于建模。下表显示了用于构建模型的标记原子的总数:
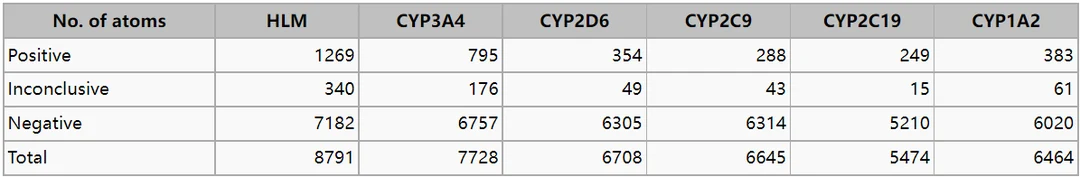
目前版本的Percepta中没有完全可搜索的细胞色素P450特异性数据库,但P450底物和抑制剂模块所做的每个预测都与来自训练集的5种化合物的实验数据一起显示,这些化合物与感兴趣的分子最相似。提供的类似化合物的信息包括相关细胞色素P450酶的底物/非底物(两个IC50阈值的抑制剂/非抑制剂)分类,这些分类是根据实验结果和原始参考文献指定的。在代谢位点预测模型中,训练集中五个最相似的化合物的代谢位点以颜色标记显示,表明是否在实验中观察到分子的特定位置发生了代谢反应。
模型特征和预测精度
所有细胞色素P450相关终点的预测模型均使用GALAS (Global, Adjusted Locally According to Similarity)建模方法推导。
05 每个GALAS模型由两部分组成:
采用二项偏最小二乘法的全局基线统计模型,使用一组预定义的片段描述符进行多次自举进行训练,这模型反映了相应性质参数的一般趋势。
基于相似性的分析,考虑到训练集中最相似化合物的基线值和实验值之间的差异,对基线预测进行局部校正。
GALAS方法还提供了评估预测可靠性的基础,通过计算可靠性指数(RI)值,考虑到:
被测试化合物与训练集分子的相似性(如果没有发现类似的化合物,预测是不可靠的);
在训练集中与测试分子相似的化合物的实验值和基线模型预测的一致性(相似分子的存在的实验数据差异较大,会导致较低的RI值)。
可靠性指数RI值范围从0到1(0表示完全不可靠,1表示高度可靠),并用于指示提交的化合物是否属于模型适用范围。RI < 0.3的化合物被认为在模型的适用性范围之外。
细胞色素P450底物和抑制剂特异性的预测模型也是可训练的,这意味着它们的适用性化学空间可以扩展,以考虑到您公司“内部”的化学结构类型,而不需要从头开始重建基线统计模型。向模块Self-training Library添加新化合物实验数据,可立即提高各自化合物类的预测精度。此外,添加“内部”数据可以使现有模型适应贵公司使用的特定实验方案,并避免与用于测定CYP450酶的药物相互作用的不同实验方法之间的差异相关的潜在问题。
如果化合物在模型适用性域(可接受的可靠性指数)内,分类的准确性和敏感性对于抑制剂接近90%,对于底物接近80%。计算机模拟预测细胞色素P450抑制的准确性与筛选结果相当。
-End-
本文内容整理自凯美科公众号文章,原文中的推广信息与联系方式已去除。如需了解相关模块与 ADME Suite 的更多信息,欢迎联系我们。