
血浆蛋白结合率与分布体积预测模型
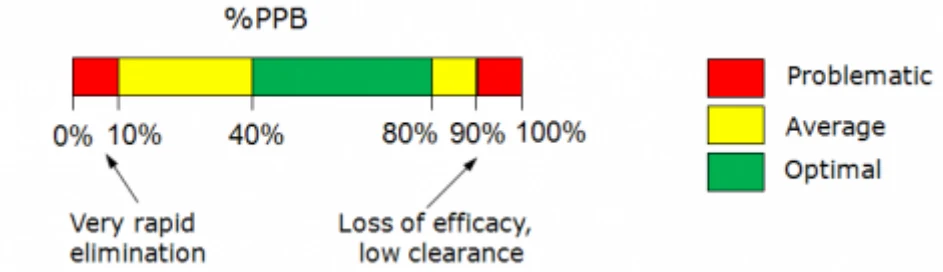
药物血浆蛋白结合率(plasma protein binding, PPB)是药物在动物体内重要的药理学参数之一,影响着药物体内游离浓度进而影响药物的处置过程。药物在进入血液后与血浆蛋白会有不同程度结合,血液中游离药物的比例会影响其在体内吸收、分布、代谢和排泄的过程,与血浆蛋白结合的药物可能会有更长的半衰期和清除速率,因此,获知血浆蛋白结合率对于理解化合物的活性以及组织分布有很重要的参考意义。
背景知识
血浆蛋白主要作为载体负责各类外源性和内源性分子在循环系统内的转运。其中参与小分子药物结合的主要有白蛋白、α-1-酸性糖蛋白(AAG)、球蛋白和脂蛋白,主要以白蛋白和AAG为主。
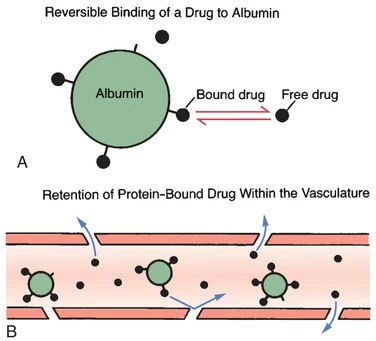
图1. 药物与血浆蛋白结合示意图。A,白蛋白是血浆中最常见的蛋白质,也是药物结合的最重要的蛋白质。B,只有未结合(自由)的药物分子才能离开血管系统。结合的分子太大,无法通过毛细管壁的孔隙。
Protein Binding模块介绍
Percepta的Protein Binding模块可用于预测化合物的血浆蛋白结合分数以及与血清白蛋白的结合平衡常数。结合性质是由化合物的亲脂性和结构描述符计算的。通过计算相应的可靠性指标(RI值)来评估每个预测结果的可靠性。
功能特色:
计算%PPB -预测化合物与人血浆蛋白(如白蛋白、α -酸性糖蛋白等)结合的累积百分比,并记录KaHSA -人血清白蛋白亲和力常数。并且提供相应预测结果的可靠性指数(RI值)供用户参考。
RI值表示预测结果置信度的定量评价。RI高表明计算值可能是准确的,而RI低表明训练集中不存在数据一致的类似化合物,参考价值较低。
在预测结果旁边的文本注释中列举了主要的血浆蛋白,这些蛋白主要有助于人体血浆中不同化合物类别的结合。
提供后台数据库中5个类似的结构,以及其对应的血浆蛋白结合程度,人血清白蛋白亲和力常数实测数据和相应的文献来源。
预测界面
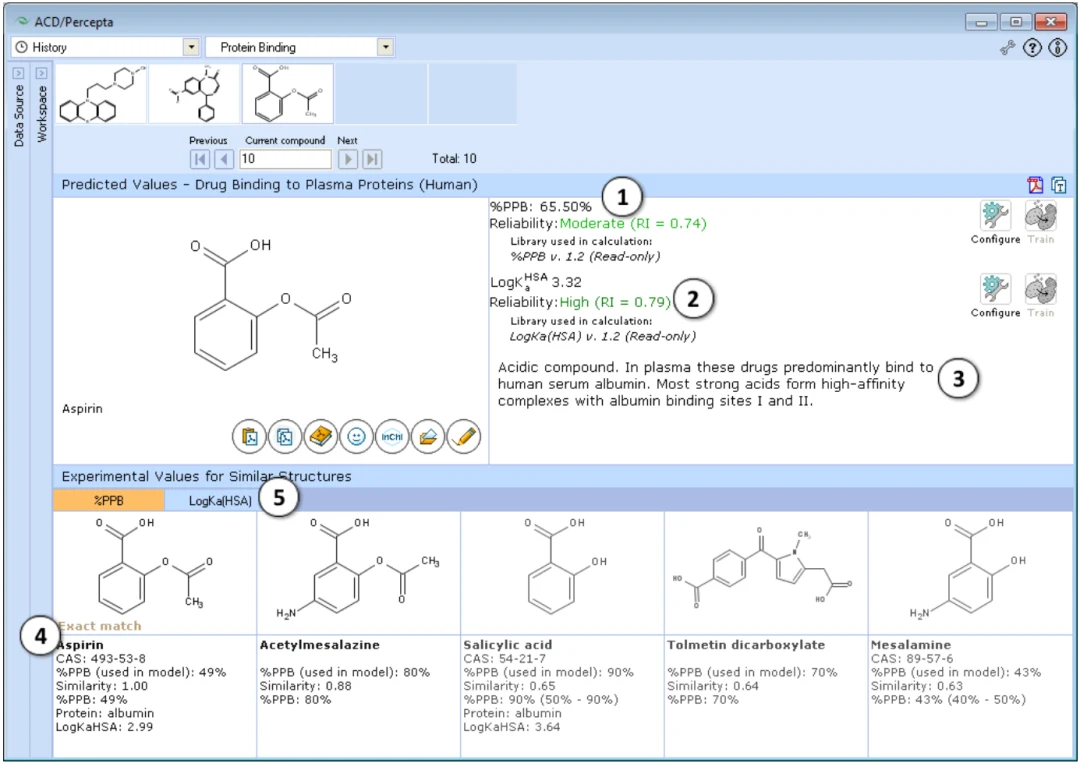
2.计算的可靠性指数(RI)。每个属性都有专门的“Configure”和“Train”按钮,用于选择用于预测的训练库,并向该库添加新数据。当前所选库的名称用斜体表示;
3.当化合物分子存在于血液时,根据其物理化学性质对其可能的结合行为作一简要的概括描述;
4.展示后台数据库中多达5个相似的分子结构,以及对应的%PPB, LogKaHSA实验测量值为和文献来源;
5.用户可在选项卡之间切换显示%PPB和LogKaHSA数据库类似结构的信息;
- 注:根据可靠性指数(RI)值划分预测可靠性等级:
- RI < 0.3 -不可靠,
- RI在0.3-0.5范围内-较低可靠性
- RI范围0.5-0.75 -中等可靠性,
- RI >= 0.75 -高可靠性
- Vd模块介绍
Percepta的Vd模块是基于机制性原理预测人体稳态下的表观分布体积Vd值。该预测模型基于Oie-Tozer药代动力学方程进行计算,解释了药物在血浆和组织中的结合程度。因此,计算使用辛醇/水logP(组织结合的主要决定因素)和血浆中未结合部分(fu,plasma)作为可定制的输入参数。
预测界面
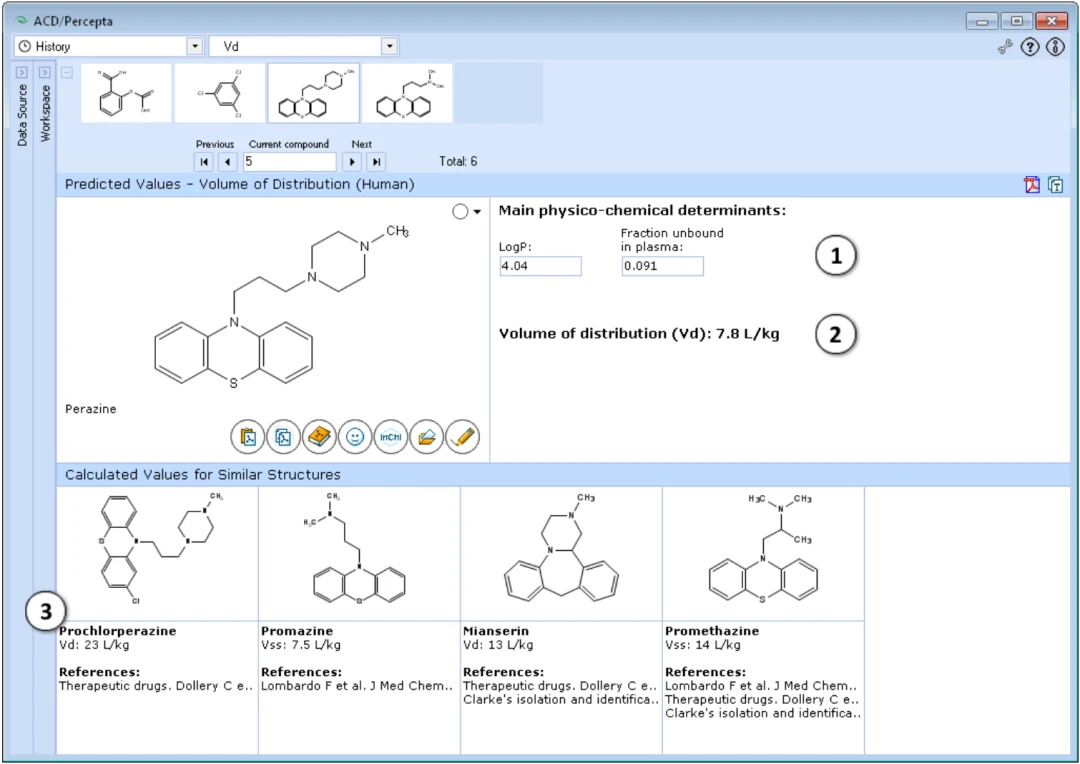
1. 软件默认提供logP和血浆未结合分数(fu, plasma)的预测值。用户可改变这些值来模拟化合物的亲脂性和血浆蛋白结合对其在组织分布的限制效应。
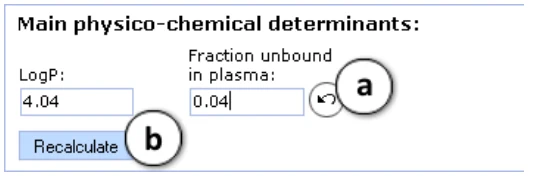
a.点击“撤销”按钮,恢复一个化合物的自动计算属性值(在本例中为fu,plasma),并使用默认参数值重新计算Vd;
b.单击"Recalculate",使用当前配置的参数值重新计算Vd;
2. 计算得到的表观分布体积Vd结果:
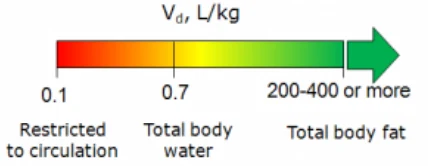
3.展示后台数据库中5个最相似的分子结构,以及对应的实验Vd值和参考文献。
01 定量计算参数
由Vd\Protein Binding 模块计算的参数包括血浆蛋白结合值百分比(%PPB)和log KaHSA常数。这些属性是相关的,但它们提供的信息略有不同。
log KaHSA表示药物对人血清白蛋白(血浆中的主要载体蛋白)的亲和力常数。实验数据是基于直接色谱测定法对特定蛋白质结合强度。
log KaHSA = log ([LA]/([L][A])),其中[LA]为与白蛋白结合的配体浓度,[L]为游离配体浓度,[A]为人血浆中游离白蛋白浓度(约0.6 mM)。
%PPB值表示人血浆中药物结合的总比例,即与不同蛋白质的相互作用:白蛋白、α -酸性糖蛋白、脂蛋白、SHBG、transcortin等。血浆蛋白结合程度通常采用平衡透析、超滤或超离心方法等体外法进行测定。
%PPB = (1 - fu) * 100%,其中fu为血浆中游离(未结合)药物的比例,范围为0 - 1。
补充 :DistributionVd模块计算药物在人体内分布的表观体积,单位为升/公斤体重(L/kg)。
02 实验数据
用于构建预测模型的实验数据来自于药物处方信息、参考药代动力学表格和许多原创的文章。
Vd数据的主要来源是权威的药代动力学书籍:
《Therapeutic Drugs》(ed. by C. dollery), 和 《The Pharmacological Basis of Therapeutics》(ed. by Goodman & Gilman's)
而白蛋白亲和常数主要来自:
Valko K.等人发表的文章——J Pharm Sci. 2003;92(11):2236-48. [1]
Kratochwil N.A. 等发表的文章—— Biochem Pharmacol. 2002;64(9):1355-74. [2]
数据集包含近1500个化合物的PPB数据,约340个白蛋白亲和常数和近800个Vd值。
03 模型开发
使用GALAS (Global, Adjusted Locally According to Similarity)建模方法搭建出%PPB和log KaHSA的预测模型。
每个GALAS模型由两部分组成:
反映有关性质变化的一般趋势的全局(基线)统计模型。
基于结构相似性的分析,考虑最相似训练集化合物的基线和实验logS0值之间的差异,对基线预测进行局部校正。
GALAS方法根据计算的可靠性指数(RI)值估计预测结果的可靠性,该方法考虑到:
被测试化合物与训练集分子的相似性。
实验值与基线模型预测训练集中最相似化合物的一致性。
可靠性指数范围从0到1(0表示完全不可靠,1表示高度可靠的预测),用于指示提交的化合物是否属于模型适用性领域。预测RI < 0.3的化合物被认为在模型的适用性范围之外。
%PPB和logKaHSA预测模型都是可训练的,这意味着它们的适用性化学空间可以很容易地通过向模块自训练库添加“内部”实验数据来扩展。值得注意的是,基线统计模型不需要获取用户输入的数据后从头开始重新构建。随着新的化合物数据添加到库中,模型将自动重新训练。由于文献数据集非常稀少,模型可训练性对于预测血清白蛋白亲和常数特别有用,因此,利用大型“内部”库的能力有可能显著提高计算的准确性和可靠性。
04 END
本文内容整理自凯美科公众号文章,原文中的推广信息与联系方式已去除。如需了解相关模块与 ADME Suite 的更多信息,欢迎联系我们。