
心脏毒性 hERG 抑制预测技术指南
hERG 抑制预测模块的功能特点、操作界面与结果解读:定量 IC50 与分类双模型、GALAS 算法、可靠性指数、hERG 数据库构成,以及用内部数据训练模型的方法。
1. 概述
1.1 功能特点
2. 操作界面
- 2.1 hERG Inhibitors
- 2.2 hERG IC50
- 3. 技术信息
- 3.1 实验数据与预测模型
- 3.2 原始GALAS模型说明
- 3.2.1 数据转换
- 3.2.2 模型特征与预测准确度
- 3.2.3 模型可训练性演示
一、概述
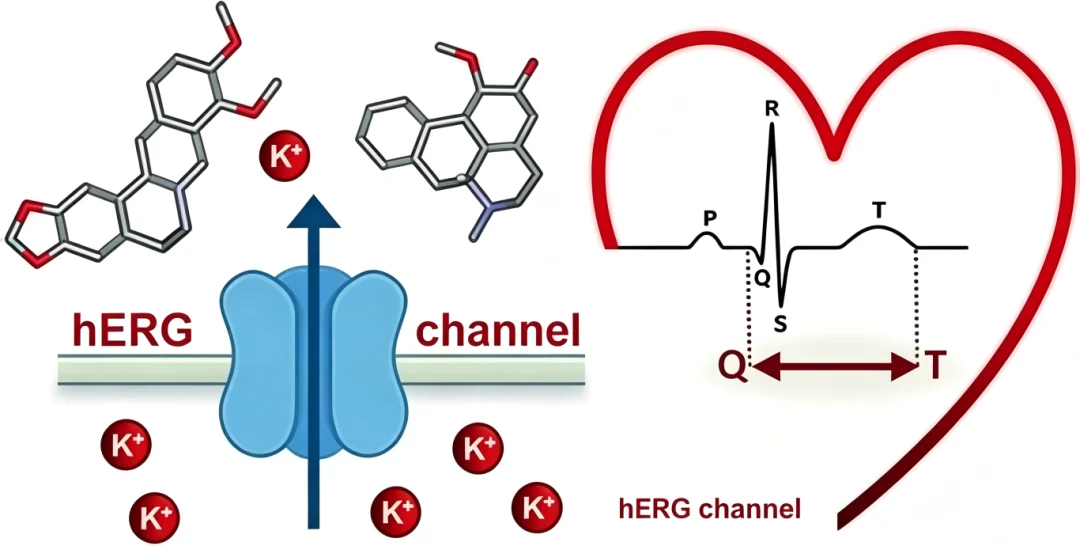
候选药物的心脏毒性是导致药物研发失败的关键因素之一,其重要致因是药物样化合物对人 ether-a-go-go 相关基因 (hERG)编码的钾离子通道的抑制作用。hERG钾离子通道是心脏动作电位复极化过程所必需,其被阻断可能导致QT间期延长,进而诱发尖端扭转型室性心动过速等危及生命的心律失常。
Percepta 平台的 hERG 抑制预测模块旨在助力药物化学家早期识别结构潜在的 hERG 抑制风险。本模块的核心优势在于其可训练性。您可利用实验室内部积累的大规模 hERG 抑制筛选数据对模型进行训练,从而显著拓展模型在内部项目化学空间的适用性,并获得更可靠的预测结果。此外,模型训练功能允许您定制预测模型,确保模型能够准确适应实验室内部特定实验方案(可能与公开文献标准存在差异)所产生的数据,这对于高质量的“构效关系”分析至关重要。
1.1 功能特点
预测化合物在临床相关浓度下 (Ki < 10 μM)抑制hERG通道的概率。
预测基于包含近9400个化合物的数据集,其实验结果来源于已发表的、采用膜片钳或竞争性结合方法的hERG抑制研究。
计算预测的可靠性指数,用于指示被测试化合物是否属于预测模型的适用范围。
执行相似性搜索,并显示模型训练集中结构最相似的5个化合物,包括其名称、实验结果和文献参考文献。
支持使用"内部"数据训练模型,包括由内部筛选方案产生的数据。
hERG_IC50模块可探索药物关键理化性质对其hERG抑制倾向的影响,并以预测的IC50值形式提供抑制效能的定量估算。
01 重要提示
如果您以专家用户权限原地升级安装了Percepta,hERG抑制模块将继续使用您先前安装中配置的同一套自训练库。如果您是从2021版或更早版本升级而来,则该库将不包含自2022版起软件随附的、新的、已大幅扩展的内置库。要利用此库,您需要点击"配置"并手动选择以下条目:hERG-I (Ki小于10 uM) 版本1.4 (只读)。
如果是全新安装,或使用有限用户密钥升级,此库将自动被选中,无需进一步操作。
二、操作界面
2.1 hERG Inhibitors界面
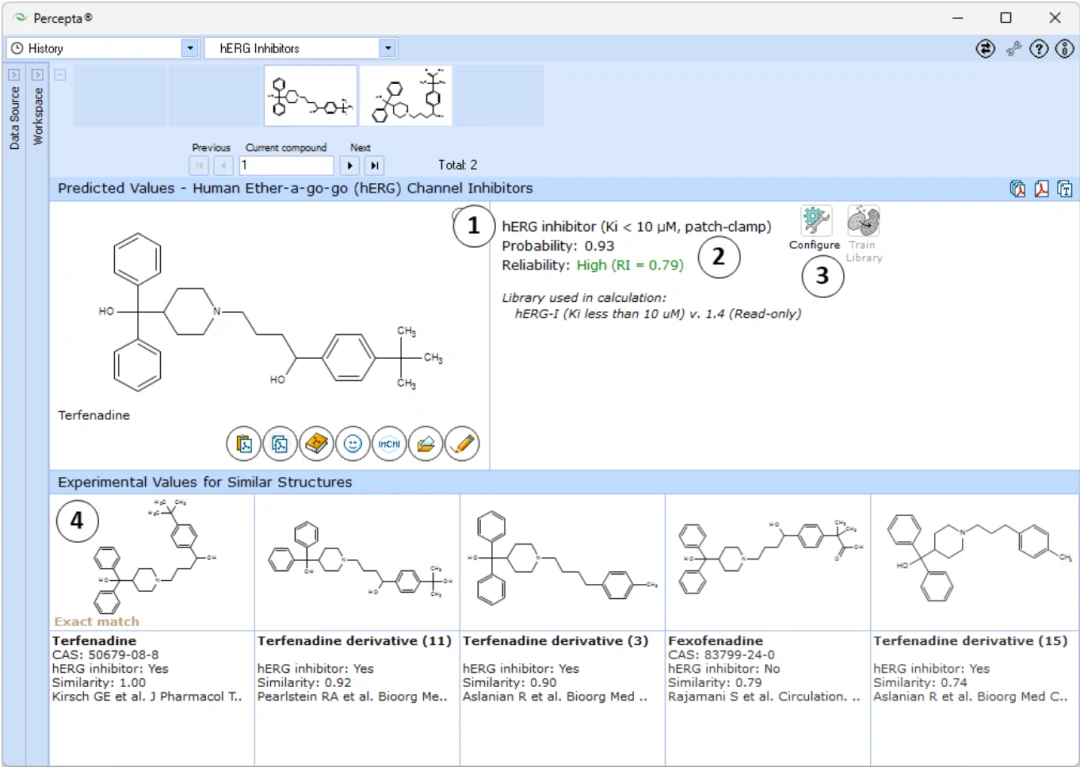
1. hERG抑制剂概率
估算的化合物成为hERG通道抑制剂的概率(0-1之间)
2. 预测可靠性指标
RI < 0.3:不可靠
- RI 0.3-0.5:临界可靠性
- RI 0.5-0.75:中等可靠性
- RI >= 0.75:高可靠性
3. 训练库配置
"Configure(配置)"与"训练(Train Library)"按钮用于选择计算所基于的训练库,并允许向该库添加新的实验数据。
当前选定的库名称以斜体字显示
4. 相似结构
- 显示来自自训练库中结构最相似的5个化合物,包括:
- 化合物名称
- 实验分类(抑制剂/非抑制剂)
- 文献参考文献
2.2 hERG IC50界面
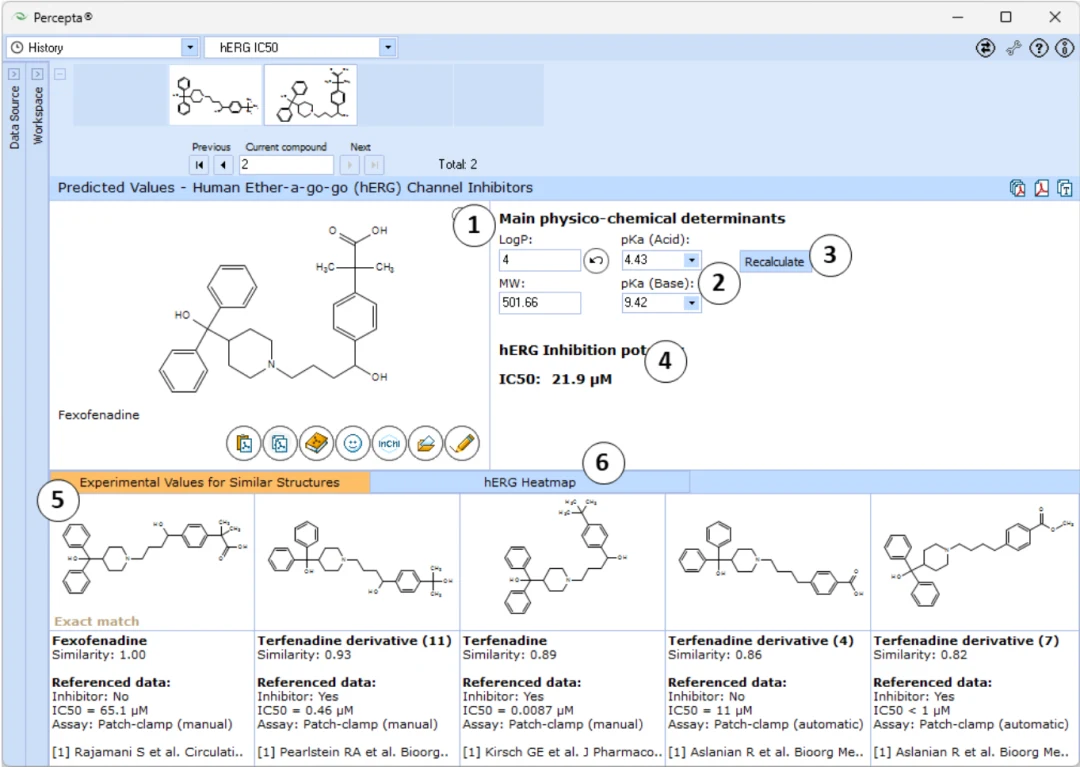
1. 关键理化性质描述符
作为计算输入的核心理化参数。通常使用自动计算的默认值。
输入实验值可提高预测准确性,或输入自定义值以模拟特定性质对化合物hERG抑制潜力的影响。
2. 参数操作
“撤销”按钮:将所有手动输入的参数值恢复为自动计算值,并触发hERG抑制效力的重新计算。
“重新计算”按钮:使用当前界面指定的所有参数值,重新计算hERG抑制效力。
3. hERG半抑制常数
预测的化合物hERG半数抑制常数IC50
4. 相似结构与数据
显示训练集中最相似的5个结构,包括
化合物名称
实验结果
所用测定方法类型
文献参考文献
5. "热图"分析
以热图形式展示hERG抑制潜力对亲脂性和电离参数的偏依赖关系
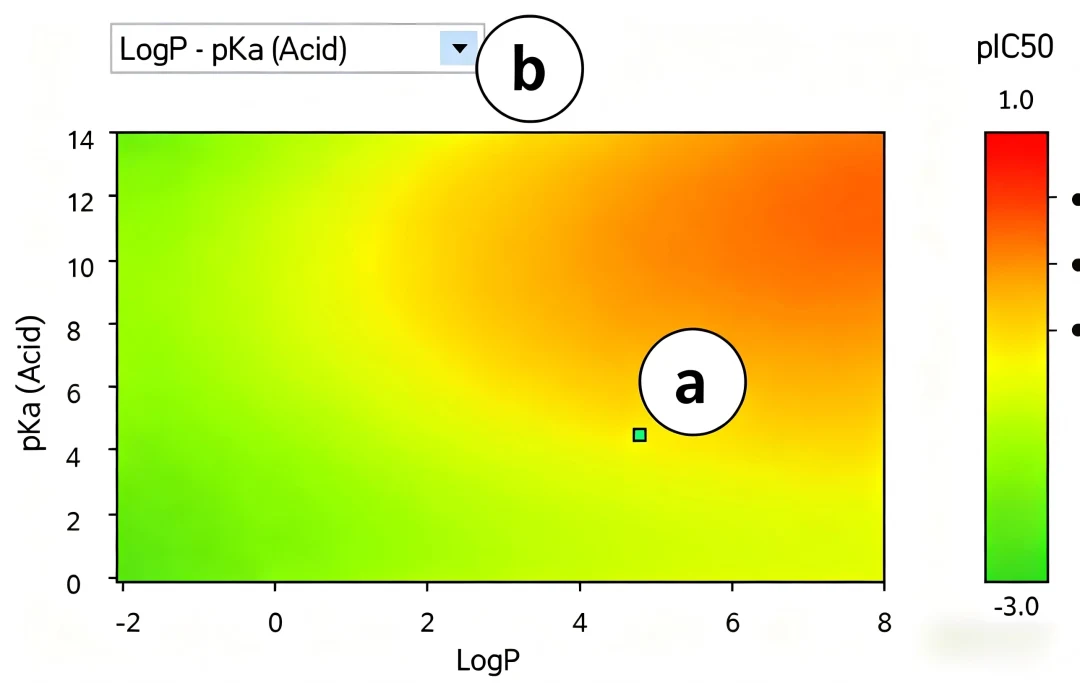
点击可切换绘制的变量组合
- LogP vs pKa (酸性)
- LogP vs pKa (碱性)
- pKa (酸性) vs pKa (碱性)
三、技术信息
3.1 实验数据与预测模型
当前版本hERG抑制模块中包含的内置库,包含9383个化合物的实验数据,这些数据通过膜片钳(传统和自动化)和竞争性放射配体置换测定获得。数据来源于ChEMBL数据库及原始文献。关于数据收集和处理流程的详细信息,可参考J Comput Aided Mol Des.2016;30(12):1175-1188. [1]
hERG抑制模块组包含两个不同的模型
1. hERG IC50 模块
这是一个基于物理化学性质的定量构效关系 (QSAR) 模型。该模型利用一组经过精简的理化描述符(如辛醇/水分配系数 LogP、酸碱性 pKa、分子尺寸、拓扑结构及柔性参数)直接预测 IC50 值。关于该模型的开发方法学、描述符选择及模型验证性能的技术细节,请参考:J Comput Aided Mol Des. 2022;36(12):837-849. [2]
2. hERG Inhibitors 模块
这是一个概率性的全局自适应局部模型 (GALAS)。该模型最初基于一个包含663 个分子的高质量定量数据的小型数据集构建。下文将详述此原始“基线”模型的关键信息。在软件当前版本中,此基线模型已经过使用包含 9383 个化合物的完整数据库进行再训练,以最大化对药物相关化学空间的覆盖度,从而实现最佳预测性能。
3.2 原始 GALAS 模型说明
3.2.1 数据转换
为将连续活性的实验数据转换为 GALAS 模型所需的二元分类数据,采用了以下标准:
02 膜片钳研究数据
IC50 < 10 μM 的化合物被视为hERG抑制剂
IC50 > 10 μM 的化合物被视为hERG非抑制剂
03 放射配体置换测定数据
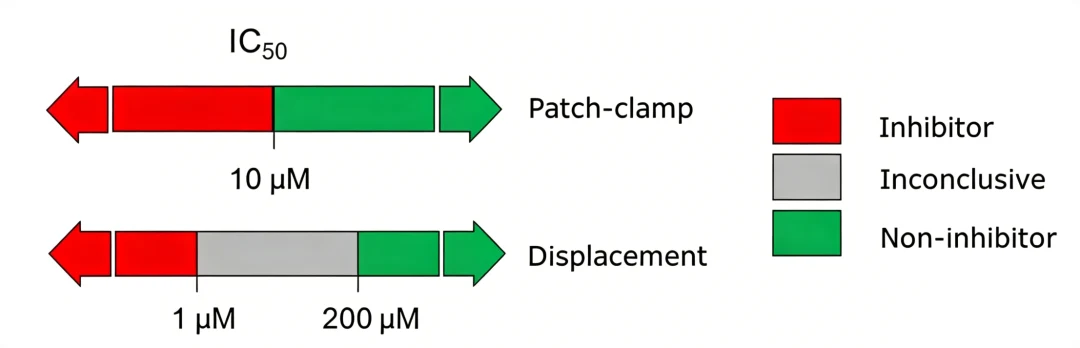
中间值范围(0.5 μM < Ki < 100 μM)的化合物被标记为不确定
之所以对放射配体置换数据应用更严格的标准,是因为该方法测量的是hERG结合亲和力,而非直接的通道抑制活性。为确保数据集的高质量,仅将足够强或足够弱的结合物分别视为抑制剂或非抑制剂,而对具有中等结合亲和力的化合物不进行明确分类。
3.2.2 模型特征与预测准确度
GALAS 建模方法的完整方法论细节可参考SAR QSAR Environ Res.2010;21(1):127-48. [3]
每个GALAS模型由两部分组成
全局基线统计模型:使用二项偏最小二乘法结合预定义的片段描述符,反映hERG抑制潜力的总体趋势。
基于相似性的校正程序:根据训练集中最相似化合物的基线预测值与实验值之间的差异,对基线预测进行局部校正。
GALAS方法学还通过计算0到1的可靠性指数来评估预测的可靠性,RI值基于以下两个标准:
被测试化合物与训练集分子的相似性(若未找到相似化合物,则预测不可靠)
训练集中最相似化合物的实验值与基线模型预测值的一致性(相似分子的数据存在矛盾,即交替出现hERG阻断剂和非阻断剂,会导致RI值降低)
该方法为核心功能——模型可训练性——奠定了理论基础。“可训练模型”旨在解决药物研发中的一大痛点:内部项目化合物库的化学多样性往往远超公开数据集,导致大多数第三方 QSAR 模型在分析内部化合物时预测域外、性能不佳。本模块的“训练引擎”能够识别并校正基线 QSAR 模型在特定化学子空间产生的系统性预测偏差。
通过将用户新增化合物的实验数据导入自训练库,可立即提升对该化合物及其类似物的预测准确性。更重要的是,整合“内部”数据使模型能够适应公司内部特定的实验方案,从而规避因不同实验室或不同测定方法(如膜片钳 vs. 高通量荧光法)间存在的系统性差异所引入的偏差。
对于处于模型适用范围内的化合物,其预测准确性与实际筛选结果相当。不可靠的预测,可以通过在模型自训练库中添加少数相似化合物的实验数据,得以即时改善。
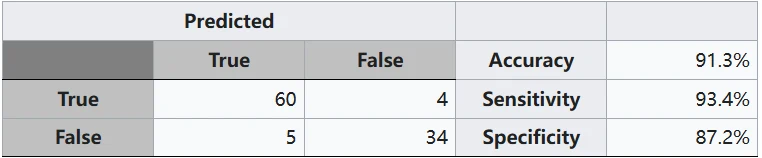
下表展示了模型在包含151个分子的内部验证集上的性能表现。在模型适用范围内的103个化合物(占验证集的68.2%)的预测具有高度准确性:
3.2.3 模型可训练性演示
为验证 hERG 抑制预测模型的可训练性与适应性,我们使用了一个来源于 PubChem 数据库的高通量荧光测定外部数据集进行了系统测试。验证流程如下:
数据准备:从 PubChem 提取 1609 个化合物的高通量荧光测定数据。将数据库中的定量活性分数转换为二元分类:
PubChem 活性分数 > 40% 的化合物视为 hERG 抑制剂;
分数介于 -20% 至 20% 之间的化合物视为非抑制剂。
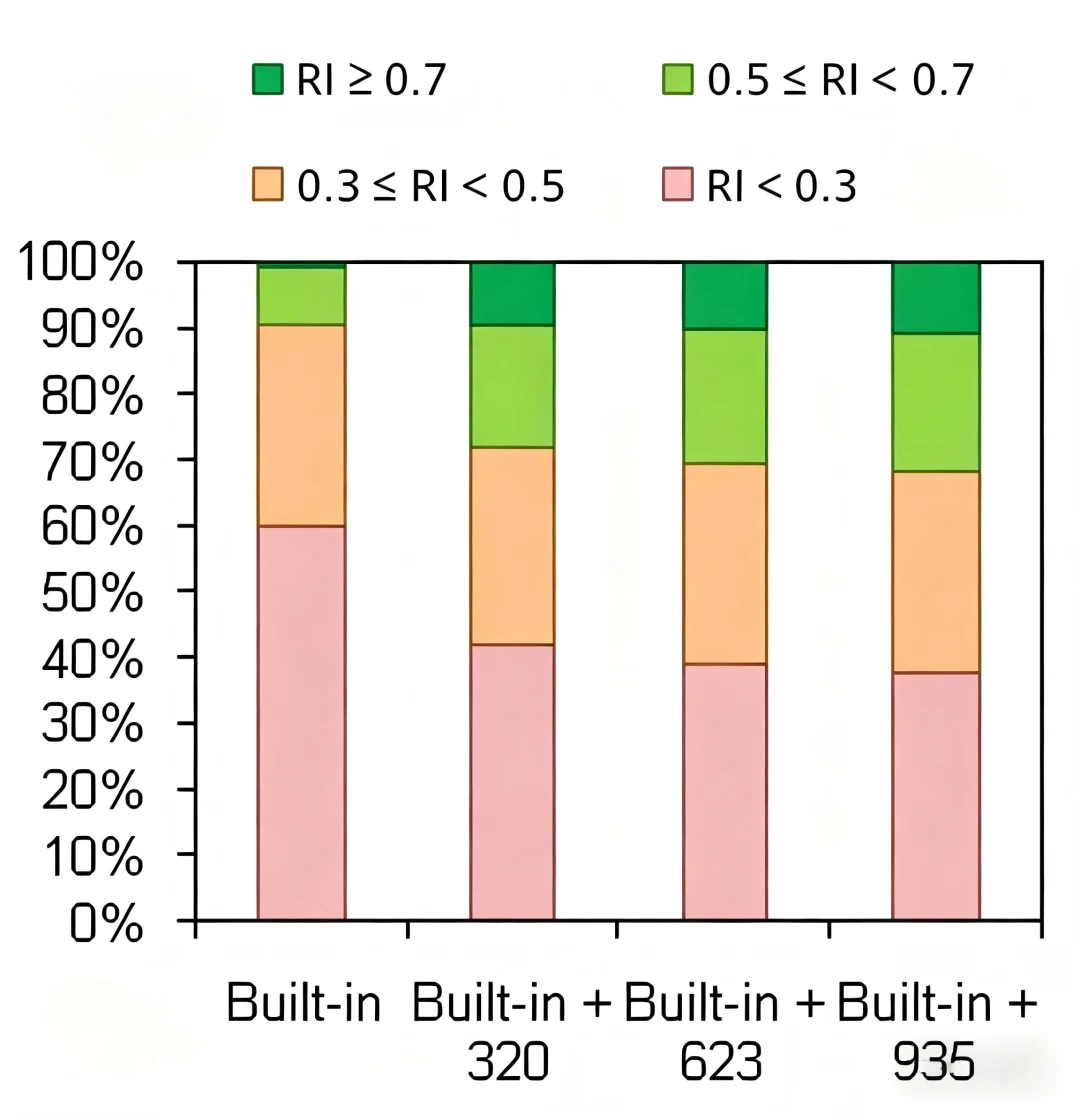
实验设计:将此外部数据集的一部分保留作为独立的测试集。其余数据则分三步、按不同比例逐步添加至软件的自训练库中。
模型验证:将使用不同比例外部数据训练后的新模型,与固定的保留测试集进行对比验证,评估其预测性能变化。
04 结果分析
基线性能:当仅使用原始内置自训练库对测试集进行预测时,众多化合物的预测因缺乏相似参考结构而被标记为“不可靠”,即落在了基线模型的适用范围之外。
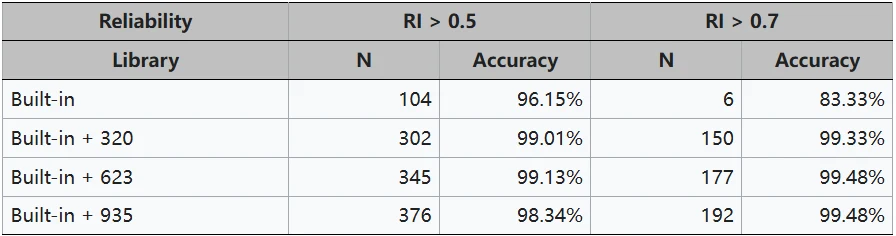
可靠性提升:然而,即使仅考虑达到临界可靠性 (RI > 0.3) 以上的预测,其准确率已表现良好。关键在于,即使仅将一小部分(如 320 个) 外部数据集纳入自训练库,也能显著增加具有中等可靠性 (RI > 0.5) 和高可靠性 (RI > 0.7) 的预测数量。随着自训练库的进一步扩展(添加至 623 及 935 个数据点),可靠预测的比例持续显著上升,同时整体的预测准确率保持稳定甚至略有提升。
05 结论
以上演示结果充分证明了“可训练模型”方法能够有效使现有模型适应并覆盖新外部化合物集所代表的化学空间。同时,训练引擎能够成功识别并校正因不同实验测定方法(如膜片钳与高通量荧光法)间存在的系统性差异。因此,该模型平台特别适用于整合与利用药物研发机构积累的“内部”专有数据,实现预测模型的持续优化与个性化定制,从而为早期药物研发决策提供更精准、更可靠的心脏毒性风险评估。