
药品杂质与降解物的遗传毒性预测:Impurity Profiling
Impurity Profiling是 Percepta软件平台的一个模块,它提供一系列预测工具,协助研究人员评估药品中杂质和降解物的遗传毒性和致癌潜力。这种计算预测的结果需要由专家进行进一步分析。因此,本指南的目的是帮助研究人员正确解释由软件提供的原始结果。
01 介绍
Impurity Profiling 包含于Impurity Profiling Suite内。由于Impurity Profiling 预测的终点很多,因此要比只预测Ames test的软件的解读要复杂的多。如果读者发现自己的研究只关注Ames test的预测结果,请主要参考Impurity Profiling Suite的Ames Test模块。
02 关于监管指南的理解和说明
管理使用计算机工具进行遗传毒性评估的关键文件,即ICH M7 指南:“Assessment and Control of DNA Reactive (Mutagenic) Impurities In Pharmaceuticals To Limit Potential Carcinogenic Risk”。美国食品和药物管理局(FDA) 和欧洲药品管理局(EMA) 以及中国国家药品监督管理局都在遵循使用。
在监管指南里写道
A computational toxicology assessment should be performed using (Q)SAR methodologies that predict the outcome of a bacterial mutagenicity assay. The absence of structural alerts from two complementary (Q)SAR methodologies (expert rule-based and statistical) is sufficient to conclude that the impurity is of no mutagenic concern, and no further testing is recommended.
If warranted, the outcome of any computer system-based analysis can be reviewed with the use of expert knowledge in order to provide additional supportive evidence on relevance of any positive, negative, conflicting or inconclusive prediction and provide a rationale to support the final conclusion.
翻译为:可以用计算毒理学的方法使用构效关系方法对细菌突变实验的预测。没有警示结构且用两种互补的构效关系计算方法(专家规则和统计学规则)一致预测没有致突变性风险则可以结论杂质没有致突变性风险,不需要进行进一步的检测。
如有必要,专家可基于知识对任何基于计算的结果进行复核以对任何阳性,阴性,相互矛盾或无结论的预测提供附加的支持证据以对最终结论提供合理的支持。
在指南里并没有规定除了细菌突变实验之外还需要对多少个终点或者特定的哪些终点进行预测,它强调了人工评估的重要性。这和FDA曾发表的数篇文档里重点强调的WOE(Weight of Evidence) 方法相一致,即用所有可获得的信息来判断是否存在毒性风险,数据越多,基于这些数据所做的结论越有力。
03 软件的特点
Impurity Profiling的统计学方法模型内包含21个和基因毒性以及致癌毒性相关的终点(endpoint)并基于原理进行了分组。21个终点数量超过同类型的软件。这些终点以及终点内包含的训练集分子的数量,列于表1内。
这些模型和软件内的专家系统互联,内嵌的专家系统能够识别文献中列明70种毒性警示结构。其中33种为致基因突变,24种为致染色体畸变,13种表观致癌物等。
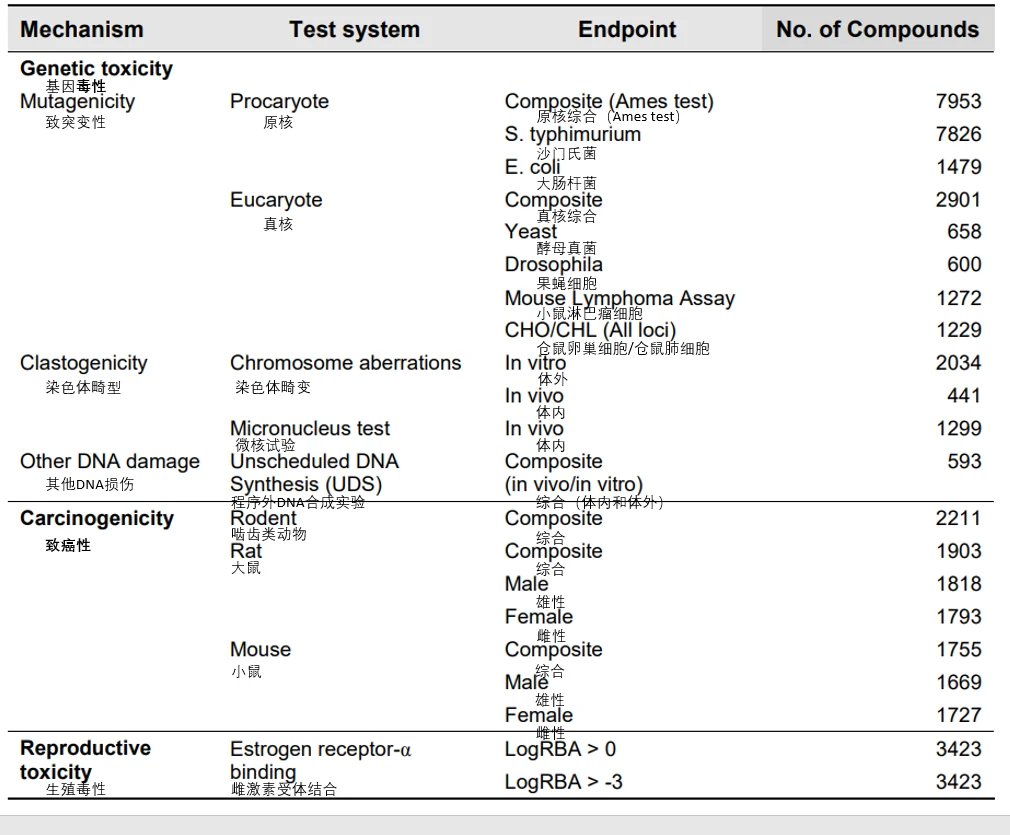
表1,Impurity Profiling的所有endpoint终点的内嵌训练集的数据组成
模型以GALAS(Global, Adjusted Locally According to Similarity)建模技术构建,GALAS内建有评估模型应用范围(Model Applicability Domain ,AD)的机制。每个模型直接输出的预测的结果为:
p-value: 针对某指定类型的终点的阳性结果的可能性,从0-1
RI: 置信指数,一个定量的评估模型适用范围的指标。数值从0-1,其结果取决于被测试分子和训练集内分子的相似程度以及与训练集内最相似的分子的实验数据的一致性。
除此之外,软件会直接给出一个特定的Call值来总结有关的结果并帮助进行结论,其分类如表2.
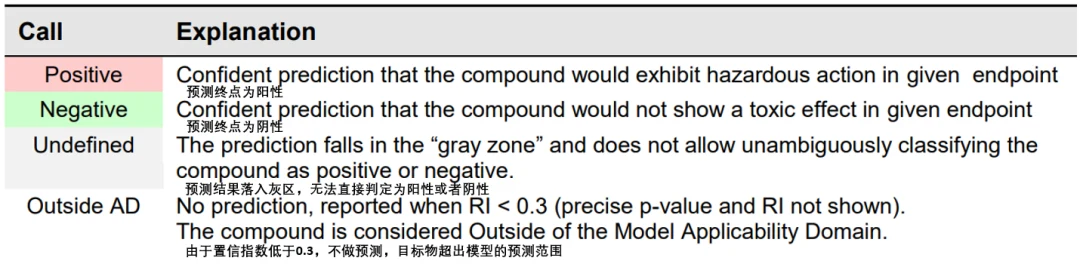
04 表2. Call(+ or -)的可能的输出结果的解释
05 对预测的解读
理想情况下,人们会期望测试化合物在所有的(或者绝大多数的)统计学的应用覆盖范围之内,或者在化合物没有警示结构时同样给出阴性的预测结果,或者在有警示结构时在某些特定的终点上有明显的阳性预测结果。
然而,在实际的应用时,并不是如此完美,在某些情况下甚至会体现出矛盾的情况。除此之外,还有出现大量的“Undefined”以及“Outside AD”的预测。因此当处理这样的案例时,我们需要牢记以下的规则。
当绝大多数的endpoint的预测结果为“Undefined”或者“Outside AD” 时
考虑,最相关的或者最有代表性的endpoint有明确的预测结果:
要考虑到每个assay的内置的数据库都不相同,因此其覆盖的化学空间有所不同,尤其有些体内模型的数据相当有限,具体请参见表1,对其终点值的预测会出现Outside AD.
另外,如果连化合物的细菌综合模型(标准的Ames test)的预测都给出Outside AD,则所有Assay的预测都可能有问题,此时建议进行实验测试。
雌激素受体结合assay是检测一类特定的有毒物质,通常被测试的化合物都会是阴性结果,尤其是LogRBA>0时。除非被测化合物和训练集的化合物的相似度很低。
检查是否可以通过专家系统的输出对缺失的信息进行补足。在专家分析窗口,每个被软件识别的警示结构都以树形结构来显示所有的从内建的数据库里提取的含有该警示结构的分子集合,并且用一个Z-Score打分来描述这个警示基团的存在是否能够显著提高阳性率。这些 Z 分数还突出显示 毒性作用的机制,因为有风险的基团通过特定的机制起作用,通常仅在相应的endpoint中显示为阳性。 这样的警示结构可能表明有必要测试特定机制(例如,clastogenic 或非遗传毒性致癌活性),而它们的缺失可作为缺乏毒性的证据,即使相应的统计预测是不确定的或在 AD 之外。
考虑模型给出的原始输出结果。例如,致癌性终点的实验数据集分子数量中等,很多化合物都会在训练集的预测范围之内,但依然会有“Undefined”的结果。这是因为Impurity Profiling 在进行阳性和阴性判断时使用了非常严格的规则。对于非诱变性化合物来说,如果它没有警示结构,致癌性的p-value较低(低于0.3),即使是”Undefined” 或者置信指数处于边界范围,总体的风险依然偏低。
考虑所有有关测试毒理学特征的任何特定信息,可能会推翻软件给出化合物的结论。 例如,一些众所周知的药物可能在遗传毒性试验数据中的覆盖率很低,因为它们历史上已知是安全的,并没有进行具体的测试。
06 当没有警示结构但出现一些阳性预测的结果时
通常建议通过实验来获得结论
首先,由于软件中给出的最终的call时所应用的原则是很保守的,任何阳性的结果都表明这种化合物的潜在毒性。
其次,没有特征明确的警示结构并不能排除毒性的可能性。
07 当没有阳性预测call结论,但存在警示结构时
建议对警示结构进一步进行调查。ICHM7里定义了一些情况可以豁免进行实验测试:
目标化合物的警示结构和已经确认过没有致突变性的药物分子或者工艺中间体相同。
有充足的证据推论目标化合物的警示结构不具备致突变性和致癌性。
这两种情况下,指南提出可以将之作为非致突变杂质处理,不需要进行实验测试。对于后者,证明其缺乏毒性作用的相关资料可以通过分析类似分子的实验数据获得。由Impurity Profiling 生成完整的PDF报告,每个终点的相似结构列表会在完整第2-3节报告中提供。
08 参考文献
https://www.ich.org/fileadmin/Public_Web_Site/ICH_Products/Guidelines/Multidisciplinary/M7/M7_Step_4.pdf
Matthews EJet al. Regul Toxicol Pharmacol. 2007; 47(2):115-35.
Matthews EJet al. Regul Toxicol Pharmacol. 2007; 47(2):136-55