
亲脂性预测:logP 模块
该模块用于计算化合物的脂水分配系数(辛醇-水)——LogP。在Percepta软件的许多物理化学和ADME预测模块中,包括LogD、口服生物利用度、血脑屏障渗透和被动吸收,以及一些毒性模块,如hERG抑制或水生毒性,都是在LogP的预测结果基础上进行的预测。目前,ACD/Labs的logP预测准确性得到业界的高度认可,无论是期刊文献或者是权威的数据库,如SciFinder、ChemSpider等都采用了ACD/Labs的logP预测算法作为数据支撑,下面我们对该预测模块进行介绍。
概述
01 功能简介
包括两种不同的预测算法- LogP Classic和LogP GALAS算法。另外,还有基于这两个模型预测结果进行权重计算得到的Consensus logP;
通过95%置信区间(LogP Classic)或可靠性指数(LogP GALAS),提供预测可靠性的定量评估;
通过颜色标注化合物结构的亲脂和亲水部分;
允许用户添加实验数据进行模型训练,以改进对专有化学空间的预测准确性。
02 LogP GALAS介绍
LogP GALAS模块提供了基于GALAS (Global, Adjusted Locally According to Similarity)建模方法预测得到的化合物(中性状态下)辛醇-水分配系数(详情请参阅[1])。
每个GALAS模型由两部分组成:
反映有关性质变化的一般趋势的全局(基线)统计模型。
基于相似性的分析,考虑到最相似训练集化合物的基线和实验LogP值之间的差异,程序会对基线进行局部校正。
GALAS算法还提供可靠性指数(RI)值,评估预测结果的可靠性,该方法基于以下两点进行计算:
被测试化合物与训练集分子的相似性;
在训练集中与测试分子相似的化合物的实验LogP值和基线模型预测的一致性。
可靠性指数RI值范围从0到1(0表示完全不可靠,1表示高度可靠),并用于指示提交的化合物是否属于模型适用性领域。RI < 0.3的化合物被认为在模型的适用性范围之外。
此外,LogP GALAS算法提供了一个颜色编码的预测性质分布,表明化合物结构的亲脂和亲水部分。
模型的内部验证
在模型构建之前,LogP数据库中的化合物被随机分成两部分,分别用于构建模型的训练集和用于验证的测试集:
训练集大小:11,387
内部验证集大小:4,890
验证结果如下表所示:
03 表1. LogP GALAS模型内部验证集的性能统计
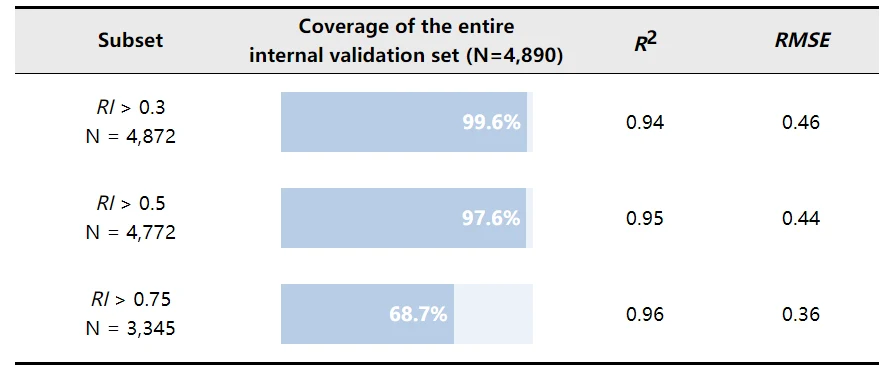
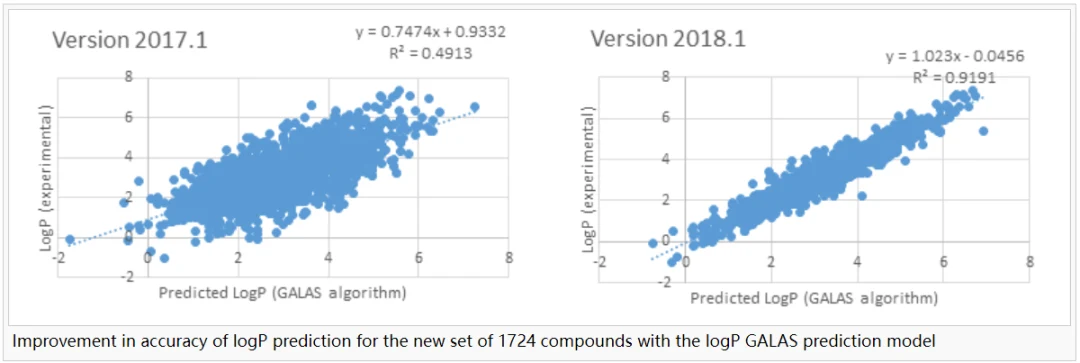
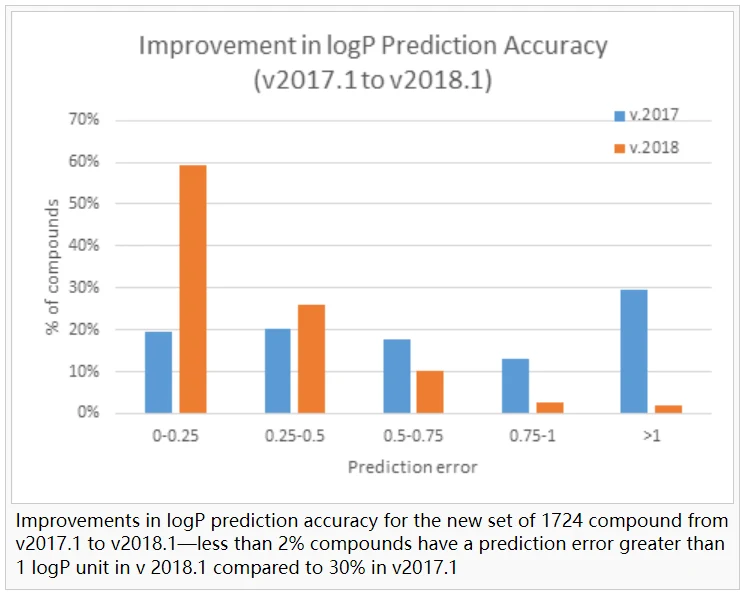
以上统计数据适用于内置“LogP v. 1.2”自训练库的LogP GALAS算法。当前版本使用了更新的“LogP v. 1.3”库,该库由超过1700个类药化合物(大小增加了12%)进行扩充,从而提高了对新实体化合物预测的准确性和可靠性: 这些化合物中85%的LogP预测在0.5 log单位以内,如下图所示:
04 LogP GALAS预测界面
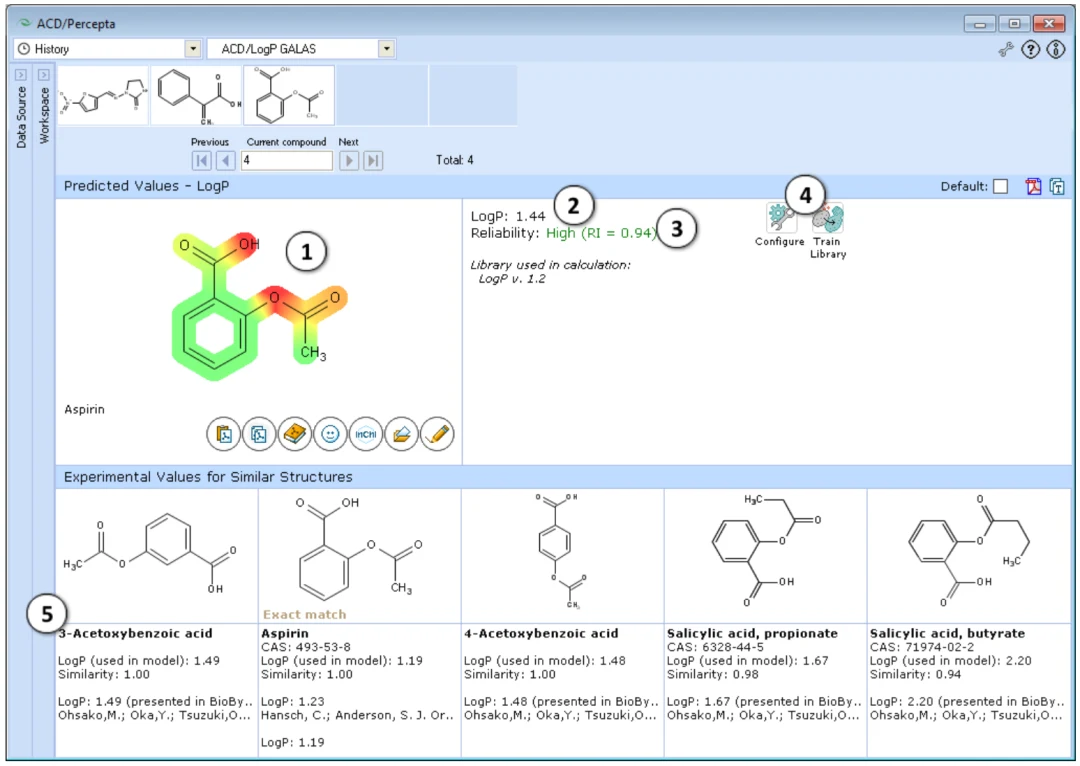
1、分子的亲脂性部分用绿色表示,亲水基团用红色表示,颜色的深浅表示原子或亚结构的亲脂性或亲水性的强度;
2、采用LogP GALAS算法得到的LogP预测结果;
3、预测可靠性指数(Reliability index,RI):
RI < 0.3—不可靠,
RI在0.3-0.5—临界可信范围,
RI在0.5-0.75范围内—中等可靠,
RI >= 0.75—高度可靠。
4、点击“Configure”按钮,用户可选择不同的模型训练集;点击和“Train”按钮,用户可向该库添加新的实验数据进行模型训练;
5、显示来自LogP数据库中5个最相似的化合物,并由对应的实验值和文献来源参考。
05 LogP Classic介绍
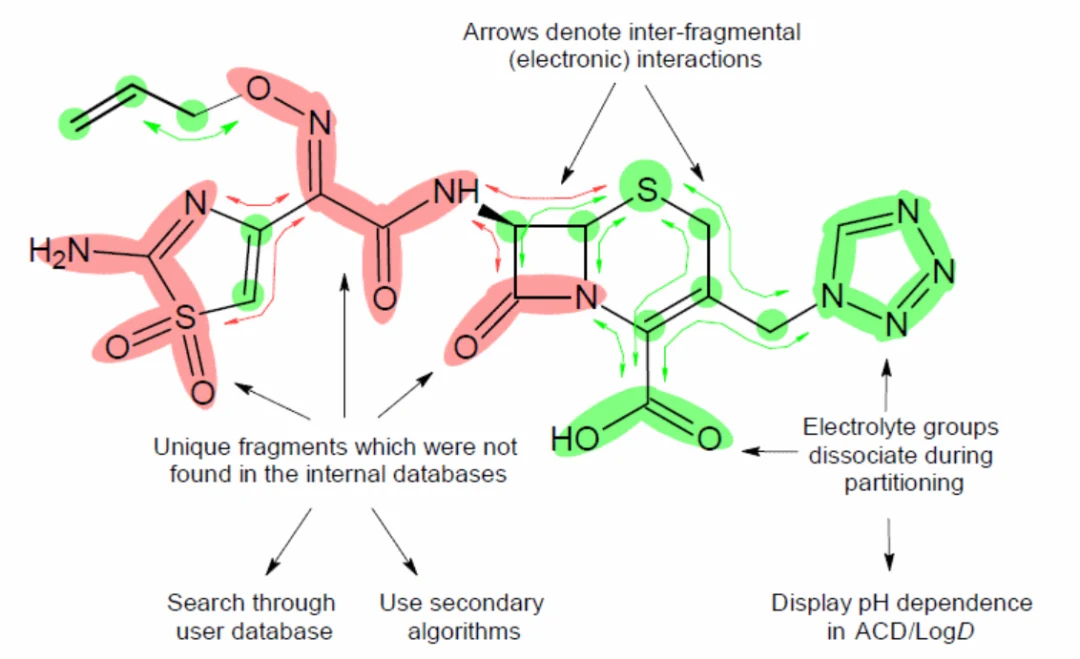
当输入一个结构进行计算时,LogP Classic算法会执行以下操作:
1、将结构拆分为多个片段;
2、在内部数据库中搜索相同的片段:
2.1 Fragmental Increments数据库包含了超过500个不同功能基团的结构片段。它们的化学结构(例如,酰胺、羧基、酯等)、与碳氢化合物骨架的连接(脂肪族、乙烯基或芳香族)、环化(环或非环)和芳香性(非芳香族、芳香族或融合芳香族)各不相同。
2.2 Carbon Atom Increments数据库包含不同类型的碳。它们的区别在于杂化状态(sp、sp2或sp3)、连接氢的数量、分支(一级、二级、三级或四级)、环化(环或非环)和芳香性(非芳香性、芳香性或融合芳香性)。
2.3 Intramolecular Interaction Increments 数据库包含了超过2000种不同类型的成对基团相互作用的数据。它们的区别在于相互作用的末端基团的类型(见上面官能团之间的差异),以及相互作用的基团(脂肪族、芳香族和乙烯族)之间的碎片系统的长度和类型。
2.4 在指定的用于训练集的数据源中搜索相同的片段(更多信息请参见附录D)。
3、如果在上述任何一个数据库中都没有找到片段,则使用二级算法估计它们的增量(以及片段间交互的增量)。
该算法估算了异构平衡和离子平衡的概率,计算误差,并给出了计算结果。
局限性
1、LogP Clasic算法不计算以下化学结构的LogP值:
带电荷的结构不能计算,除非是两性氨基酸及其多肽衍生物,以及与氧(-)或以双键与氮(-)结合的iv价氮(+)的非离子衍生物之外的带电结构;
包含C, H, O, S, N, or F 等以外原子的结构,或者包含 P, Cl, Br, I, Se, Si, Ge, Pb, Sn, As, or B 原子的结构(以下图示的连接结构除外)
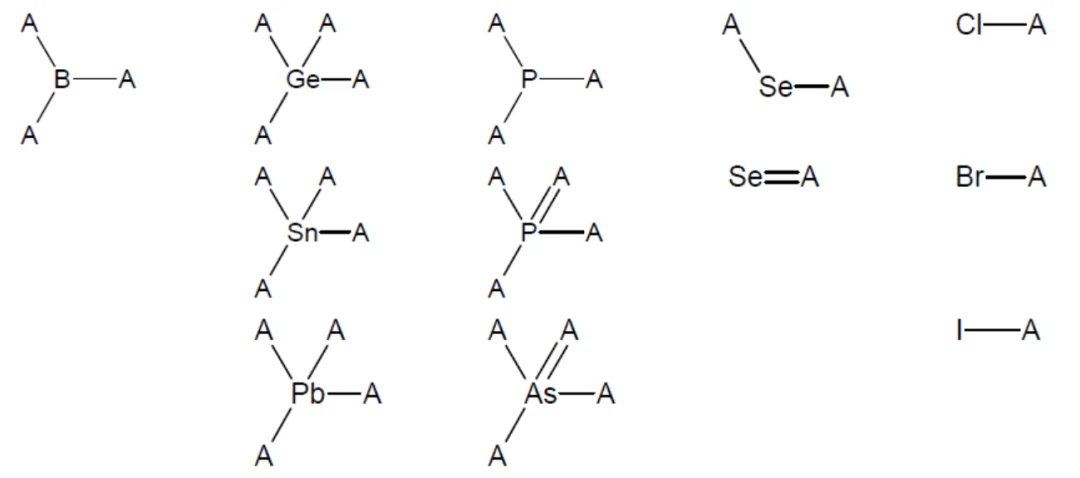
注:图中除sp3杂化硒烯外的基团不能是环的一部分。
含有非典型价电荷的元素的结构;
有配位键的结构;
包含255个以上原子的结构,不包括氢原子。
2、该算法没有考虑到不同几何异构体、立体异构体、构象、同位素和非共价键结构的具体特征。
3、在大多数情况下,可靠的实验测量值位于计算的±logP区间内。然而,一些新的化学结构仍有可能具有新的特定的结构特征,如远距离非共价键、分子内屏蔽或分子间缔合。在这种情况下,可能会出现新测量的实验值与计算的±logP区间之间的差异。
06 基于结构片段计算方法的示例说明:
07 LogP Classic预测界面
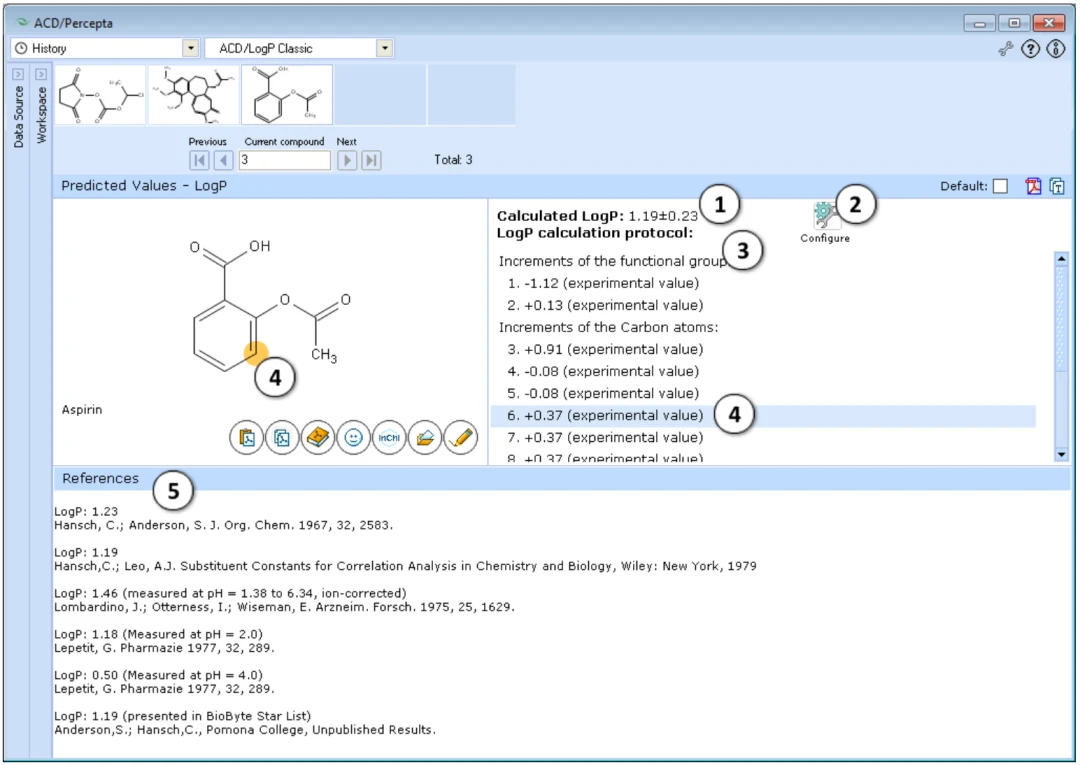
2、点击“Configure”键,可选择用于训练的数据库文件。
3、列出所有官能团和碳原子的贡献值,以及通过脂肪族、芳香族和乙烯族体系的相互作用的贡献。
4、单击任何条目可突出显示相应的原子、基团或分子上的相互作用。
5、如果该化合物在软件的LogP数据库中找到,则显示该化合物的所有实验数据以及参考文献。
08 Consensus LogP介绍
Consensus LogP是将LogP Classic和LogP GALAS两个算法预测的结果进行加权平均。根据预测质量指标,对每个模型赋以动态自适应系数。因此,在化学空间中性能最可靠的区域的算法结果获得更大的权重。所提供的方程列出了两个模型获得的权重系数和最终计算得到的LogP值。
09 Consensus LogP界面
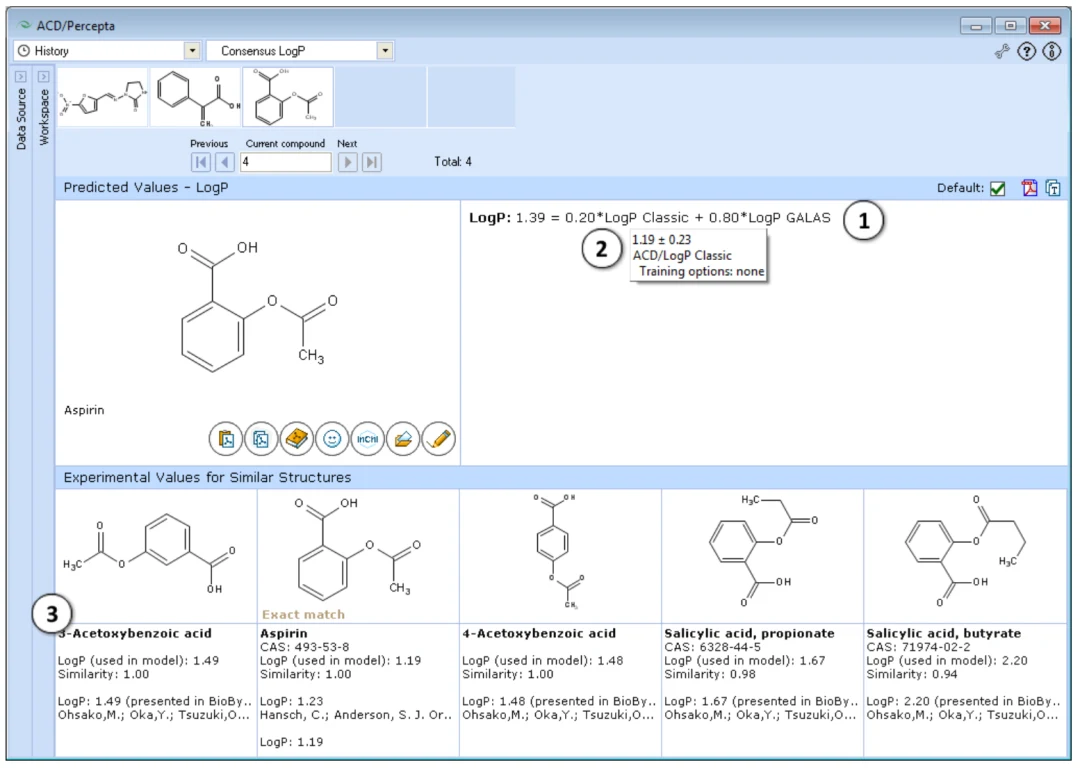
2、将鼠标悬停在显示的公式中的算法名称上,可以查看 Log P Classic和GALAS算法的预测细节(计算值、可靠性和训练选项);
3、从LogP数据库中搜索得到了5个最相似的化合物,并给出了实验值和文献来源。
什么时候计算的LogP比实验的更精确?
首先,我们需要知道的是,LogP是一个宏观度量。LogP参数与其他性质的关联性实际上是基于logP是单分子性质的假设。但在许多情况下,测量这种“纯热力学”的logP值是非常困难的,甚至不可能通过实验获得。
传统实验方法测得的logP值的上下限分别为+8.0和-3.0左右。在这个范围之外获取可靠的logP值是非常困难的;
在大多数情况下,不可能对所有单独的互变异构体分别测量对应的logP值;
目前还没有办法测量各种氨基酸、多肽、核苷和任何其他既含酸性基团(例如-COOH或-PO3H2)又含碱性基团(例如-NH2)的化合物的不带电分子的准确logP值。 在任何给定的pH值下,这些分子几乎完全以各种离子形式存在,氨基酸和类似形式的非离子种类的浓度可以忽略不计;
有些化合物在必要的条件下是不稳定的或不存在的,例如在抑制酸碱平衡所必需的极端pH值下。
在以上这些情况下,与实验测量值相比,计算得到的logP值很可能具有更高的可靠性。
10 END
本文内容整理自凯美科公众号文章,原文中的推广信息与联系方式已去除。如需了解相关模块与 ADME Suite 的更多信息,欢迎联系我们。