
对预测模型进行训练的重要性
在评估一款预测软件时(在此,我们主要是讨论性质预测软件,如理化性质、ADME/Tox性质等QSPR预测模型软件),预测准确性是首要考虑的问题。虽然预测算法的质量会一定程度上影响其准确性,但更重要的一个因素是该预测模型是否涵盖了用户所需预测化合物的化学空间。如果用户的化合物结构落在了预测模型训练集的化学空间之外,这会使预测结果可靠性大打折扣。这时候,我们可通过拓展预测模型训练集的化学空间,来提高模型的预测准确性。
01 模型的好坏取决于它所基于的数据
无论在构建模型时使用何种统计方法或描述符,该模型仅在内部数据集覆盖的化学空间内可靠适用,并且与构建该模型所依据的相关数据一样可靠。这是计算机建模的两个限制因素 。
商业的预测软件内置的数据集通常是基于公共可用数据的汇编,因为这提供了最广泛的化学空间覆盖范围。这通常意味着数据来自不同的实验室,这些实验室使用不同的实验方法来获取数据。这个数据的误差分布的范围通常是相当大的。与在单一实验室进行的测量相比,误差分布的传播将会明显地更紧密。
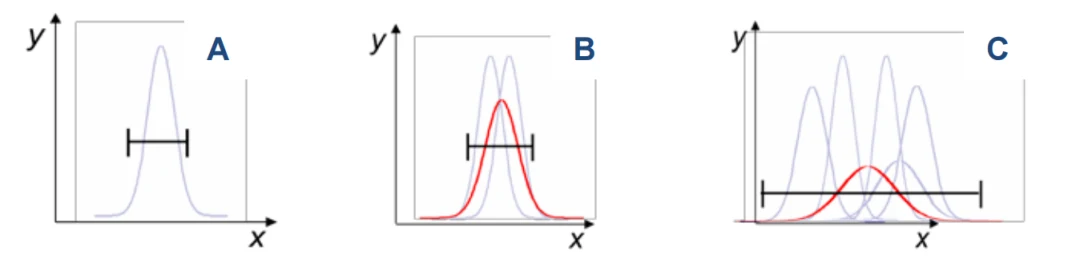
化学空间覆盖:模型适用性领域
每个预测模型都有一定的化学空间覆盖范围,由训练集——模型适用性域(Model Applicability Domain,MAD)中的化合物所决定。如果我们进行预测的化合物在这一范围内,我们将期望预测中的误差与模型验证中的误差相当。如果化合物落在这个空间之外,预测的可靠性就无法估计。第三方或者用户专属的训练集化学空间可能会在一定程度上与软件内部的训练集重叠,但有很大一部分不会重复。
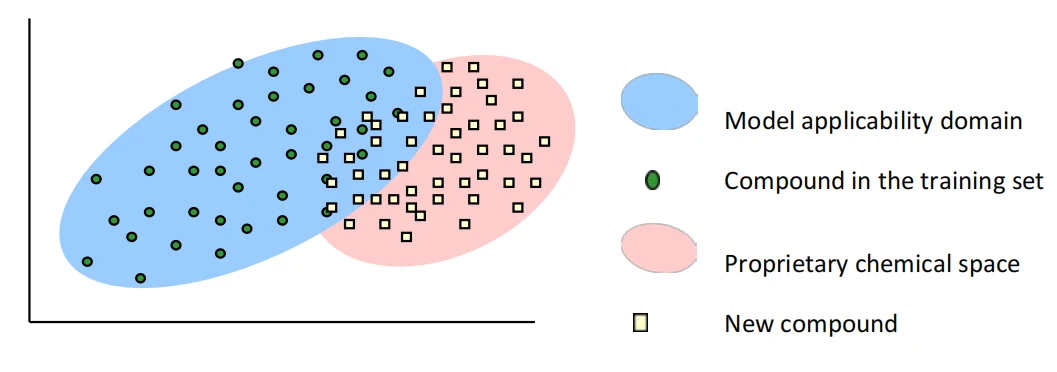
对预测模型进行训练
02 训练模型的两个主要原因
- 可以利用实验数据来提高专有化学空间的预测准确性;
- 节省了可能用于构建和验证新模型的时间。
任何市面上的预测软件都不太可能充分代表在新领域工作的研究项目所感兴趣的化学空间,从而提供“开箱即用”的,准确和可靠的预测。向模型中添加可靠的内部数据,模型的适用性范围扩展到了更广阔的化学空间,这样不仅可以提高预测精度,而且添加的数据还可能为该化学空间提供更窄的误差分布。这将提高预测的准确性,并为您的实验室/机构进行的工作定制一个模型。
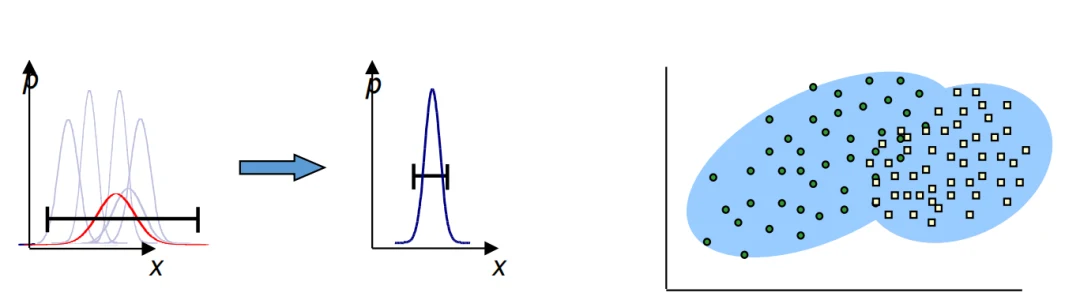
谁应该对模型进行训练?
每个人!
无论您是否可以访问来自不同项目的数千种化合物的数据,还是一个项目的有限数据,都可以为您的预测模型进行训练,增加价值。虽然添加数千种化合物的数据将使模型更广泛地适用,但添加特定化合物系列的数据,对于正在研究的具有公共骨架化合物的特定研究项目同样有价值。
使用Percepta的PhysChem和ADME/Tox预测工具,您不必成为统计或软件专家就可以对预测模型进行训练。Percepta中的大多数预测模块允许用户进行添加内部数据进行再训练,该操作简单,易于使用,并允许方便地批量添加数千种化合物的数据,或手工输入少数化合物数据。
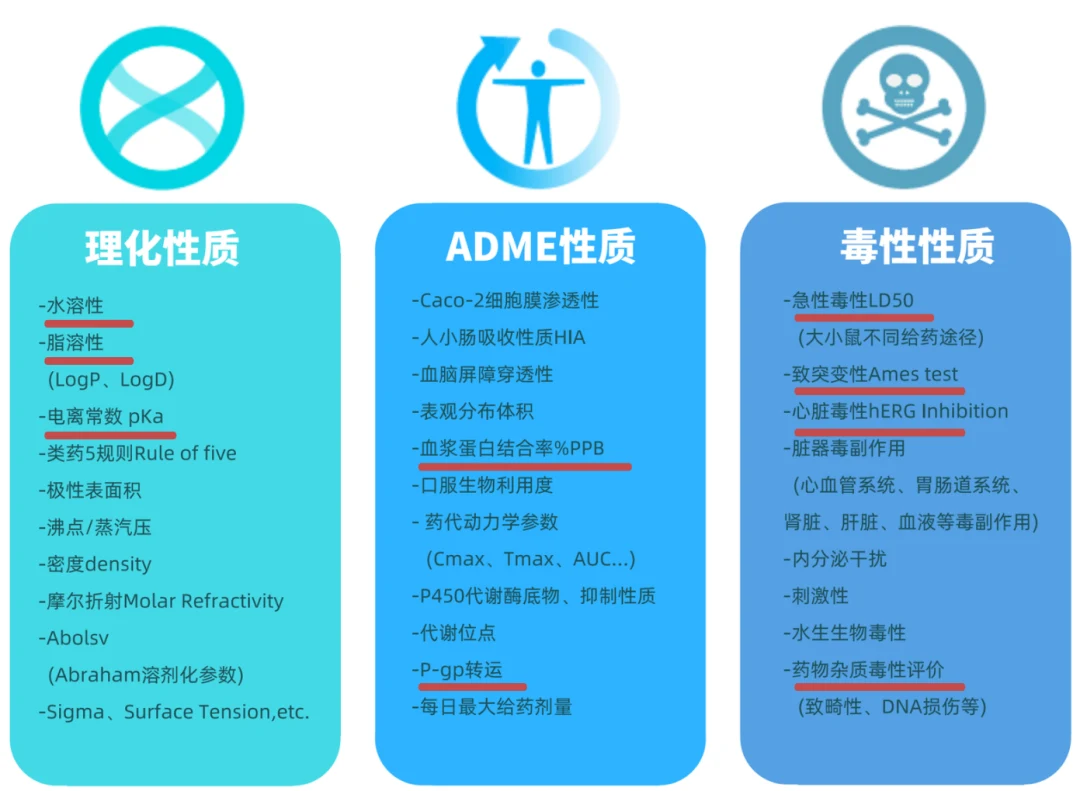
因此,无论您是开始进行软件评估,还是开始安装和使用Percepta软件,一定要询问有关培训的问题,并将其应用到您的评估/购买中以获得最佳效果。
本文内容整理自凯美科公众号文章,原文中的推广信息与联系方式已去除。如需了解相关模块与 ADME Suite 的更多信息,欢迎联系我们。