ACD/Labs 谱图数据库系统
为您的实验室打造"谱图数据中枢"
海量谱图数据库 + 专业建库工具,科研效率翻倍
数据库矩阵自建知识库多维检索NMR 谱图数据库
导读:外部权威谱图数据库解决"有没有可参照的数据",自建谱图知识库解决"自己的数据如何沉淀与复用"。本文从数据基石(NMR / MS / 色谱数据库矩阵)、知识引擎(把内部谱图与解析经验建成可检索的专属知识库)、实战价值三个层面,说明两者如何共同构成实验室的"谱图数据中枢"。
ACD/Labs 谱图数据库系统
海量谱图数据库 + 专业建库工具,科研效率翻倍
导读:外部权威谱图数据库解决"有没有可参照的数据",自建谱图知识库解决"自己的数据如何沉淀与复用"。本文从数据基石(NMR / MS / 色谱数据库矩阵)、知识引擎(把内部谱图与解析经验建成可检索的专属知识库)、实战价值三个层面,说明两者如何共同构成实验室的"谱图数据中枢"。
实验室效率痛点自查
耗费大量资源合成或分离出的"新"物质,如何快速确认其首创性,避免无效研究?
历史谱图数据分散在不同文件夹、仪器工作站甚至个人电脑中,查找所需谱图如同大海捞针。
面对一张复杂谱图缺乏可参照的相似实验数据,结构鉴定进展缓慢、试错成本高。
结构解析经验与方法优化过程仅存于个人记录甚至记忆中,随人员流动流失。
ACD/Labs 谱图数据库系统是为化学实验室打造的完整方案:它整合权威数据与智能工具,化数据为知识、化知识为效率,直接赋能科研创新的每一步。
ACD/Labs 提供一套多维度、高覆盖的谱图数据库矩阵,将全球权威数据置于您手边。
ACD 实验核磁库 · 约 40 万条
真实实验测定的碳谱、氢谱高质量数据,为结构确证和排重提供最高等级的可信度,是鉴定结果的金标准。
ACD-COCONUT 2.0 · 70 万+
收录 70 万个以上天然产物的结构及高精度预测碳谱。在复杂天然产物分析领域,数据质量与排重能力已可与实验数据库相较。
PubChem 预测核磁库 · 1 亿+
覆盖 1 亿个以上化合物的预测核磁数据,提供极大的检索范围,适用于"广撒网"式的初步筛查。
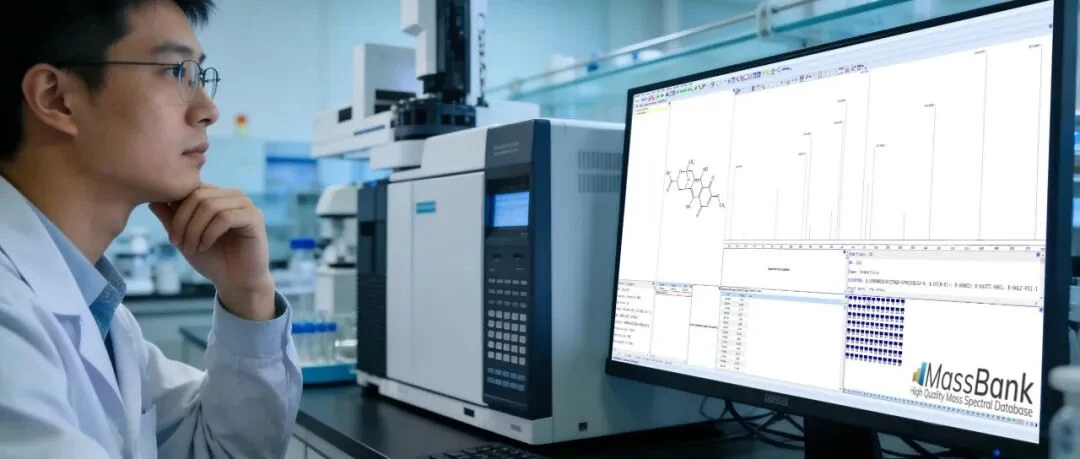
MassBank
120,000+ 张高质量唯一质谱图,覆盖 18,000+ 种化合物;数据源自全球 53 家知名机构,MS/MS 数据占比超 82%。
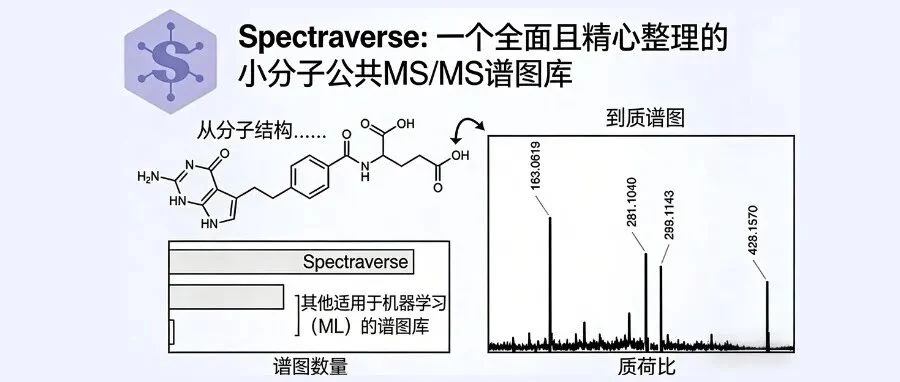
SpectraVerse
480,000+ 张高质量 MS/MS 谱图,覆盖 44,000+ 个独特小分子;整合 GNPS、MoNA、HMDB 等主流资源。
色谱应用数据库
收录 10,000+ 条来自 HPLC、GC、CE 等技术的成熟分离方法记录;每条含原始色谱图、实验参数与已鉴定化合物结构。
矩阵式布局的作用是:在任何科研场景下,都能找到与问题最匹配的数据支撑。
| 检索维度 | 核心能力 | 应用价值 |
|---|---|---|
| 化合物检索 | 支持名称、分子量、InChIKey、SMILES 等精确查询 | 快速定位已确证化合物信息 |
| 谱图检索 | 上传原始谱图,通过智能算法实现全谱相似度匹配 | 快速比对,发现最相似的已知结构 |
| 特征峰检索 | 基于特定化学位移(NMR)或质荷比(MS)进行靶向查询 | 定位含特定官能团特征的化合物 |
| 结构检索 | 支持子结构、精确结构、相似结构等多种化学智能筛选 | 发掘具有特定核心骨架的同类物 |
| 文本关联检索 | 对所有录入的样品信息、实验备注等进行全文检索 | 发掘隐含的化学和实验逻辑关联 |
仅依赖外部公共数据库远远不够。实验室每天产生的实验图谱、解析记录、优化心得,是比任何公共数据都更具价值的"私有数据资产",但这些资产常常未被有效管理和利用。您需要一个平台,将这些碎片化数据转化为可检索、可复用、可传承的集体知识。
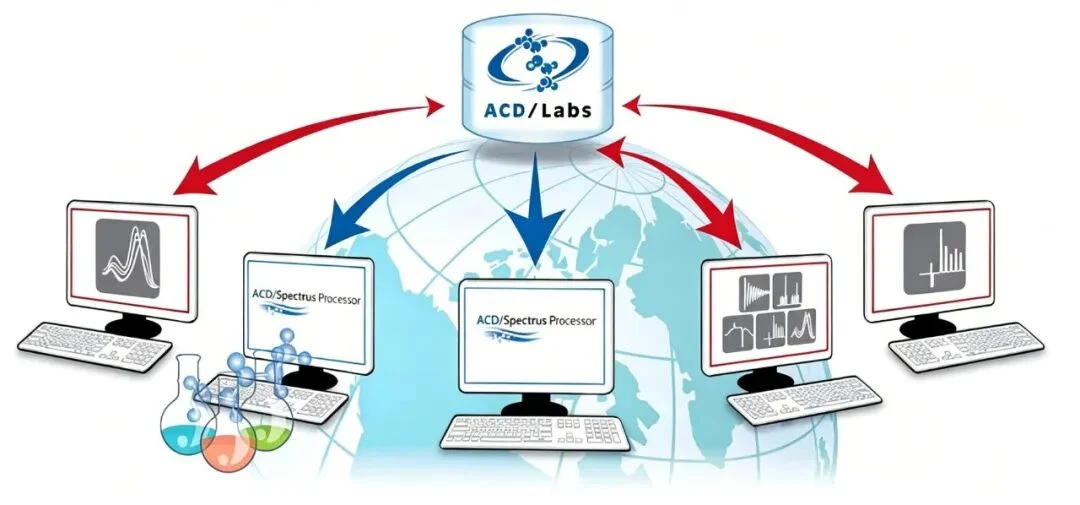
统一中枢
支持导入 LC/MS、GC/MS、NMR、UV、IR 等多种格式的原始数据,打破仪器品牌壁垒,终结"数据孤岛"。
智能关联
自动将化学结构、反应式、合成路线与相应的多维度谱图数据关联,形成完整、可追溯的"化学上下文",使数据解读回归其实验源头。
知识传承
集中存储结构、谱图、解析逻辑、参考文献,形成可随时查阅的"实验室百科全书",降低团队人员流动带来的知识损失风险。
高效检索
支持结构、谱图、文本、分子量等组合条件进行多维交叉检索,实现秒级精准定位。
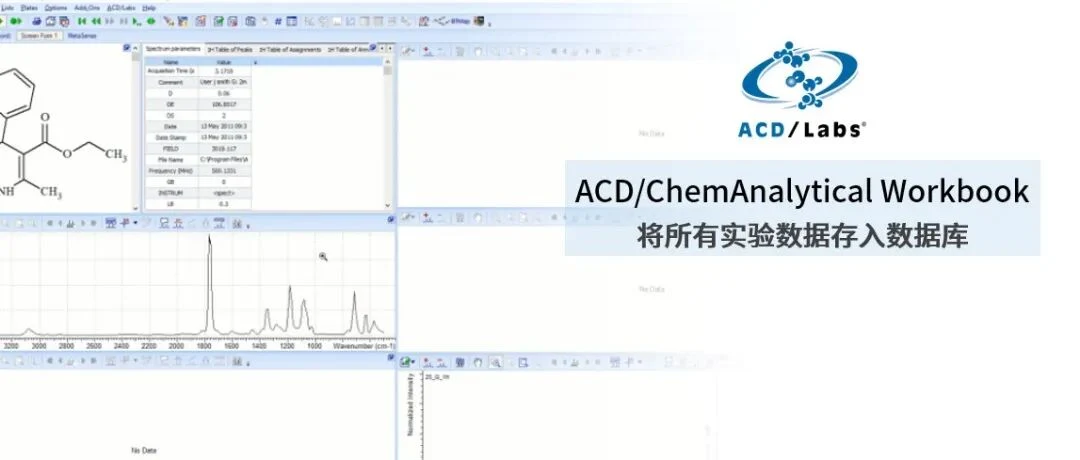
数据库 + 建库,才是完整的数据中枢:外部数据库(NMR / MS / 色谱库)回答"样品是否为已知化合物、能否找到可参照的谱图";自建知识库则把实验室自有的原始谱图、结构关联与解析逻辑沉淀下来。二者共用同一套多维检索(结构、谱图、文本、分子量)能力,形成互为补充的闭环。
| 应用场景 | 传统痛点 | 数据库 / 建库带来的价值 |
|---|---|---|
| 化合物排重 | 需查阅大量文献,耗时耗力 | 数分钟内完成数据库比对,得到新化合物是否已知的初步结论,极大避免资源浪费 |
| 结构解析 | 依赖个人经验和社群请教,试错过程漫长 | 检索相似结构的已知化合物谱图,为碎片信号归属提供关键线索,加速解析进程 |
| 方法开发 | 从零开始摸索分离条件,耗费大量时间与试剂 | 检索相似理化性质化合物的已有分离方法作为起点,直接优化实验流程 |
| 数据安全管理 | 数据存储混乱,权限不清,协作困难 | 平台统一存储,支持权限分级管理,既保障安全,又促进协作 |
| 报告生成 | 手动整理数据、绘图,生成报告耗时费力 | 基于自定义模板,一键生成包含结构、谱图、数据表格的高质量期刊级报告 |
国际
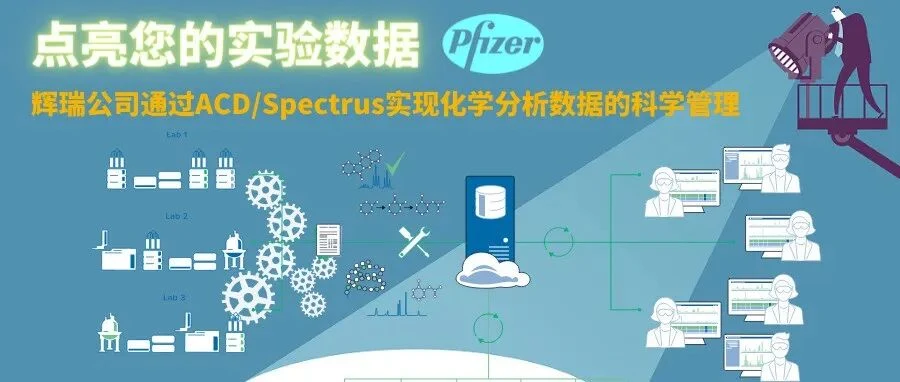
辉瑞(Pfizer)、基因泰克(Genentech)等制药企业已采用 Spectrus 平台,实现海量研发数据的集中化管理与高效复用。
国内
众多高校、国家级科研机构以及药企、CRO 已成功部署应用,覆盖项目数据共享、标准品快速比对、学生实验数据统一管理等场景。
与其让宝贵的数据继续沉睡,不如让它们通过一个"智慧大脑"连接起来,转化为驱动下一项发现的动能。从外部权威数据库的引入,到内部谱图知识库的建设,凯美科可提供产品选型、数据库配置与建库方法在内的配套支持。
说明:本文依据凯美科公众号原文整理,保留原文的内容结构与数据;文中涉及的第三方数据库名称、覆盖范围与数据规模均为原始发布条件下的客观引用。原文中的视频、二维码与联系方式推广内容未纳入。配图按原文阅读顺序排布,若发现某张配图与上下文不符,请告知具体位置以便替换。