
1.3 Structure Elucidator的知识库
在研究未知化合物时,若该化合物并非新物质,且其结构和光谱数据已收录于现有数据库中,则可通过光谱数据库搜索实现化合物的成功鉴定。即使未知化合物未包含在参考化合物库中,光谱搜索仍能基于“相似结构产生相似光谱”这一通用光谱原理,提供一组与分析物结构相似的候选化合物。然而,需要注意的是,这一原理的逆命题(“相似光谱对应相似结构”)是否成立需视具体案例而定。光谱搜索在去重复分析中同样具有重要意义,能够快速回答样品分离后的首要问题:该化合物是否为全新结构?
文献中报道的各类数据库通常用于上述目标,并作为独立资源使用。本节将重点介绍ACD/NMR 数据库,因为它是CASE 系统Structure Elucidator 的核心组成部分。
如前文所述(第1.2.2 节),利用二维核磁共振(2D NMR)数据进行结构解析在理论上可以通过从头计算(ab initio)方法实现。然而,在实际操作中,若不结合包括谱图-结构相关性、化学规则等在内的公理化知识,这种方法往往难以成功。分子结构解析是一个复杂的逻辑组合过程,涉及实验数据的处理以及事实性知识和公理化知识的综合运用。因此,一个高性能的CASE 专家系统必须依赖于一个包含事实性知识和公理化知识的强大知识库(KB)。
在本章中,我们将深入探讨ACD/Structure Elucidator 中知识库的核心特性,并详细阐述其在实际结构解析中的应用方法。
1.3.1 ACD/NMR 数据库的架构与内容
StrucEluc 系统的事实性知识由以下数据库集合构成:
数据库I:包含超过290,000 种化学结构,每种结构均标注了13C 和1H 核磁共振化学位移,并将其归属到相应的碳原子和氢原子上。
数据库II:包含355,000 种结构,同样标注了13C 和1H 核磁共振化学位移,并归属到相应的碳原子和氢原子上。该数据库经过优化,支持基于HOSE 算法的13C 和1H化学位移预测。此外,数据库II 还支持JHH 耦合常数的计算以及核磁共振谱图的图形化模拟。
其他核数据库:包括标注了15N(23,000 种)、19F(42,000 种)和31P(超过36,000种)核磁共振化学位移的结构数据库,化学位移分别归属到相应的氮、氟和磷原子上。这些数据库支持基于HOSE 算法、增量法(PLS)和神经网络算法的15N、19F 和31P 化学位移预测。
片段库:包含2,375,000 个片段,每个片段均附带其13C 和1H 核磁共振子谱,化学位移归属到相应的碳原子和氢原子上。
数据库I 和数据库II 是事实性信息的存储库,可独立用于结构或光谱(13C 和1H 核磁共振谱)搜索。这些数据库包含来自多种来源的数据,包括天然产物和有机合成化合物。所有数据均取自科学文献,涵盖了自1990 年以来在主要化学期刊上发表过核磁共振谱的几乎所有化合物。这项工作持续迭代进行,参考结构的数量不断增加。为确保数据的高可靠性,所有与结构-谱图相关的信息均经过核磁共振谱预测和人类专家检查的双重验证。如果发现结构与谱图之间存在任何矛盾,该结构将被标记为存疑,并不被纳入数据库。尽管数据库中的结构数量与化学文摘社(Chemical Abstracts Service)最新公布的约9000 万种注册化学物质总数相比显得较少(即不到总数的1%,且仅为注册物质),但数据库中几乎涵盖了所有基本类别的天然产物以及许多人工合成的有机分子类别。
每个化合物的信息包括以下内容:
结构式、分子量、测试溶剂及原始文献出处等基础数据13C 化学位移范围:分子中每组等价碳原子分别指定化学位移区间。对于特定化合物,明确标注与等价碳原子组对应的化学位移值。由于实验条件(如核磁共振仪型号、溶剂等)的差异,同一化合物在不同条件下记录的谱图可能不完全一致,因此采用化学位移区间来描述。此外,化学位移的强度通过相应信号的积分面积来表征,其数值直接对应等价碳原子的数量。
1H 化学位移范围:针对每组等价氢原子指定,并标明与每个化学位移相关的氢原子数量。数据库II 还包含与1H 化学位移相关的耦合常数值。
索引:根据化合物的化学组成及其13C 和1H 谱图中的化学位移值生成,用于加速基于光谱数据的结构搜索。
图1.9 展示了数据库I 中一个结构的示例,包括标注的13C 化学位移及相关信息。需要注意的是,分子的立体化学通过楔形键和虚线楔形键的上下约定来表示。
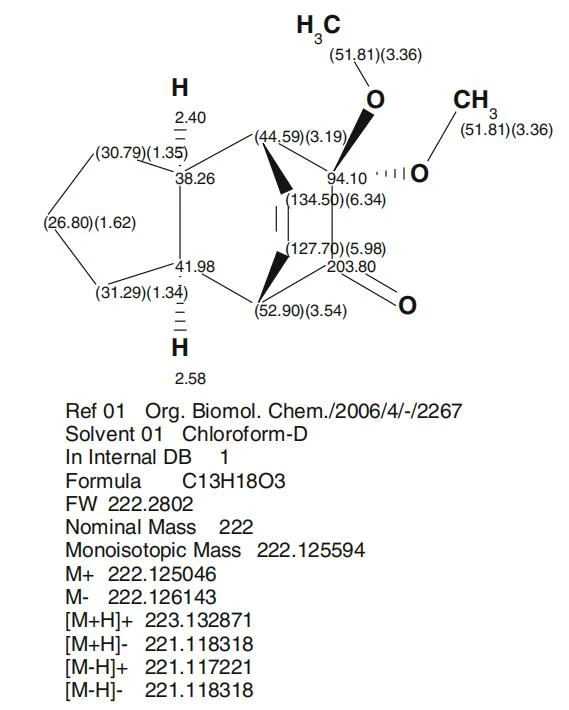
图中显示了13C 和1H 的化学位移,以及立体键(如果分子包含立体中心)。
1.3.2 基于13C NMR 谱图的结构搜索
为高效检索数据库,我们开发了一种结构搜索算法,该算法充分考虑了实验13C NMR谱图的特点。在13C NMR 谱图中,信号通常表现为窄而清晰的峰,因此可以合理假设每个峰对应一组化学环境相同的碳原子。在构建搜索请求时,算法对13C NMR 谱图的以下特性进行了优化处理:
化学位移的变异性:化学位移值可能因实验条件(如温度、溶剂等)的不同而有所变化。为此,算法引入了化学位移容差机制,以增强搜索的灵活性。
峰强度与碳原子数量的非对应性:谱图中峰的相对积分强度或峰高并不总是与对应碳原子的数量成正比,这为信号归属带来了挑战。为解决这一问题,算法允许用户指定潜在碳原子的数量,以提高匹配准确性。
杂质信号与信号缺失的兼容性:实验谱图中可能包含杂质或伪影产生的信号,同时某些碳原子(尤其是季碳)的信号可能因灵敏度不足而未被检测到。为此,算法支持在搜索选项中定义信号数量与分子式中碳原子数量的偏差,以应对这些实际情况。
氢原子数量信息:若实验数据中能够明确特定碳原子上连接的氢原子数量,则此信息亦会在搜索结果中予以标注。
此外,结构搜索还可基于以下附加条件展开:
(a) 目标化合物的可能元素组成区间,例如C20–22 H42–46 O1–2。
(b) 分子量的允许偏差范围。
1.3.3 公理化知识的构成
1.3.3.1 片段库系统的公理化知识由一系列片段库、关联表、基于不同谱图预测水平生成光谱约束的算法以及明确的化学规则构成。这些知识可按以下方式系统化:
片段库:包含子结构(主要是官能团)及其在13C、1H 和(可选的)IR 谱图中的特征光谱范围。该库主要用于过滤StrucEluc 输出的结构文件(称为过滤库)。
原子属性关联表(The Atom Property Correlation Table, APCT):包含子结构及其在13C 和1H NMR 谱图中的特征光谱范围。APCT 用于确定碳原子的属性——杂化状态以及与杂原子相连的可能性。该表在结构生成过程中也会被使用。
典型官能团库:包含有机化学中最常见的官能团。该库用于初步的结构基团分析,并构建未知化合物的“广义轮廓”。
非典型片段库:包含在大多数有机化学条件下被认为不太可能存在的片段。
化学常识规则:用于对专家系统生成的结构施加约束,例如Bredt 规则和一些几何约束。
此外,基于HOSE 算法、神经网络算法和增量法的1H、13C、15N、19F 和31P NMR 化学位移预测所施加的光谱约束具有公理化性质,可纳入系统的公理化知识体系中。
过滤库由一系列按层次结构排列的分子片段库组成,每个片段均附有其在13C NMR、
1H NMR 和(可选的)IR 谱图中的特征光谱区间。在NMR 谱图中,化学位移范围、裂分类型、耦合常数以及积分值被用作片段的特征属性。然而,IR 数据在复杂有机分子(如天然产物)中的应用存在一定局限性,因为其特征振动频率常超出常规范围,难以提供明确的解析信息。
片段库中的特征光谱数据来源于多种光谱学资源,并经过StrucEluc 数据库I 的严格验证,以确保其准确性和可靠性。这些库(数量无限制)主要分为两类:一类是包含常见化学功能团的库,另一类则是基于光谱解析常用方法选择的特定子结构片段库。
1.3.3.2 通用库
1、主要功能团库该库包含最重要的功能团,例如>C=C<、>C=O、N–H、芳香环等,并提供了这些官能团在三种不同谱图(如适用)中的特征区间。例如,无论处于何种化学环境中,羰基的13C NMR 信号通常出现在150–220 ppm 范围内,而其IR 吸收带则位于1,630–1,880 cm−1 区间。该库在过滤的初始阶段用于排除那些含有主要功能团但未被谱图确认的结构。
2、具有明确环境的常见功能团库该库同样包含常见的功能团,但提供了更为精确的功能团及其周围环境的描述。例如,C–CO–C、C–CO–O–C、CO–OH、C–CO–C=C、C–CO–Ar 等。通过明确功能团的具体化学环境,该库能够更准确地支持结构解析和验证。
1.3.3.3 专用库
1、13C NMR 专用库该库包含以不同化学环境中的中心碳原子为核心的片段。这类库在过滤生成的结构时表现出极高的效率,能够快速排除不符合13C NMR 特征的结构。
2、1H 和13C NMR 专用库该库包含三个子库(CH3-Lib、CH2-Lib 和CH-Lib),专门用于检测CH3、CH2 和CH基团,并考虑了不同化学环境及碳原子杂化状态的影响。如果片段环境中包含某些官能团(例如C=C–CH2–C=O、CH3–C=O、Ar–CH–C),则这些基团的NMR 特征被视为相应片段的重要光谱属性。
1.3.3.4 结构过滤器结构过滤器使化学家能够筛选出既符合用户设定约束条件,又遵循结构化学和立体化学基本规则的结构。结构验证提供了以下三类约束条件:
1、子结构约束该组约束条件包含三个片段库,其中两个(GOODLIST 和BADLIST)在问题启动前为空,第三个库为“不可能片段库”。GOODLIST 和BADLIST 库可分别包含由化学家根据先验知识、实验数据或理论分析引入的必须存在 (GOODLIST)和禁止存在 (BADLIST)的片段。片段结构式的输入可通过集成结构编辑器ACD/ChemSketch 完成,也可直接在GOODLIST/BADLIST 窗口中绘制。
分子骨架的约束条件可以“抽象片段”的通用形式引入,例如A=A、A=A=A、A=A–A=A,其中“A”代表骨架原子。需要注意的是,GOODLIST 和BADLIST 中的片段允许重叠。
2、不可能片段库该库包含一些在有机化学和立体化学中不太可能存在的片段,例如小环中的三键和联烯结构、高度张力的不饱和多环结构以及某些含杂原子的片段(如O–O–O、OH–C–OH 等)。如果某些“不可能片段”在特定问题背景下可能成立,化学家可在检查前将其从库中删除,或在过滤过程中禁用该库。
3、Bredt 规则控制如果分子式、不饱和度及生成片段集允许生成带有双键的桥环结构,则可能出现违反Bredt 规则的结构。Bredt 规则指出,若桥头原子处存在双键的双环结构,则包含双键的较大环中至少需要八个原子。根据该规则,结构1 是不现实的,而结构2 在原则上可能存在。
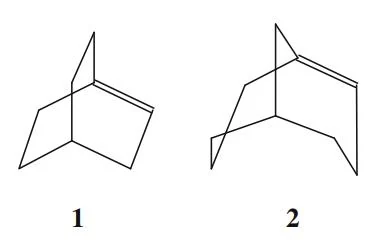
通过Bredt 规则的结构过滤,所有违反该规则的结构均会被自动排除。结构过滤器不仅是一种验证工具,还可用于在生成的结构文件较大时,逐步筛选出最可能的结构。
1.3.3.5 原子属性关联表(APCT)
原子属性关联表(APCT)是基于系统知识库构建的,其核心内容是以碳原子为中心的片段及其对应的13C NMR 化学位移区间,以及与中心碳原子相连的氢原子的1H 化学位移范围。程序利用该表自动为所有碳原子归属杂化状态(如sp3、sp2、sp,或未明确的状态),并评估碳原子与杂原子相连的可能性(禁止、必须或未定义)。若某一参数存在多种可能性且无法明确判断,则标记为“未定义”。
1.3.3.6 数据库光谱范围的优化为了优化公理化知识(包括过滤库和APCT)中片段对应的化学位移区间,程序使用了包含已归属1H 和13C NMR 谱图的数据库。通过片段库对数据库I 中的结构进行过滤,若检测到结构与片段特征光谱区间之间存在矛盾,程序会生成相应的提示信息。根据提示信息,化学位移区间会被修改以解决矛盾,或在某些情况下保持不变。如果矛盾是由结构中存在“异常”化学位移(即所谓的“奇异结构”)引起的,则不进行修改。以下是一个奇异结构的示例[28]:
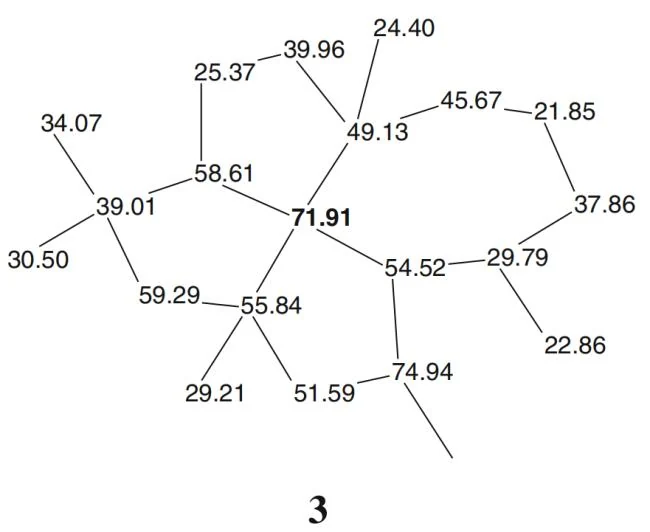
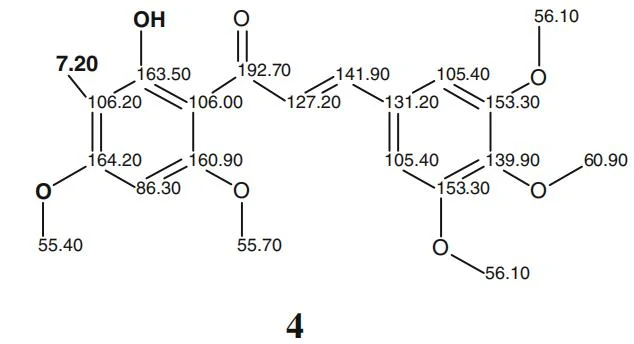
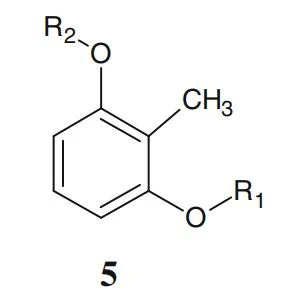
在结构3 中,作为四个环共用的季碳原子化学位移为71.91 ppm,这一数值通常出现在与氧原子相邻的碳原子上。尽管此类异常化学位移较为罕见,但为平衡解析效率与准确性,研究采用以下策略:优先使用文献中常见化学位移值解决大多数问题,同时将具有特定异常位移的片段(如结构4 中CH3 基团的7.20 ppm 低场位移)纳入“例外库”,并通过专用算法进行过滤。此类位移的成因与氧原子对β位碳的屏蔽效应相关,其累积作用类似β分支效应,导致信号向高场显著偏移。基于此,片段5(如下所示)被引入例外库:
通过对片段库的系统分析表明,结合光谱过滤库和原子属性关联表(APCT)进行结构解析时,忽略正确结构的风险可忽略不计。系统数据库中98%的结构均能通过1H 和13C NMR谱图的光谱过滤及APCT 双重验证。考虑到结构库的高度多样性,输出文件的光谱过滤流程仅存在极小的实际结构遗漏风险。
不过,若研究人员在过滤后的结构文件中未发现预期结构,可在结构生成阶段关闭过滤功能。如后文(第1.4 节)所述,Structure Elucidator 中集成的NMR 化学位移预测算法具有极高运算速度,若使用高性能计算机,甚至可跳过光谱与结构过滤步骤。
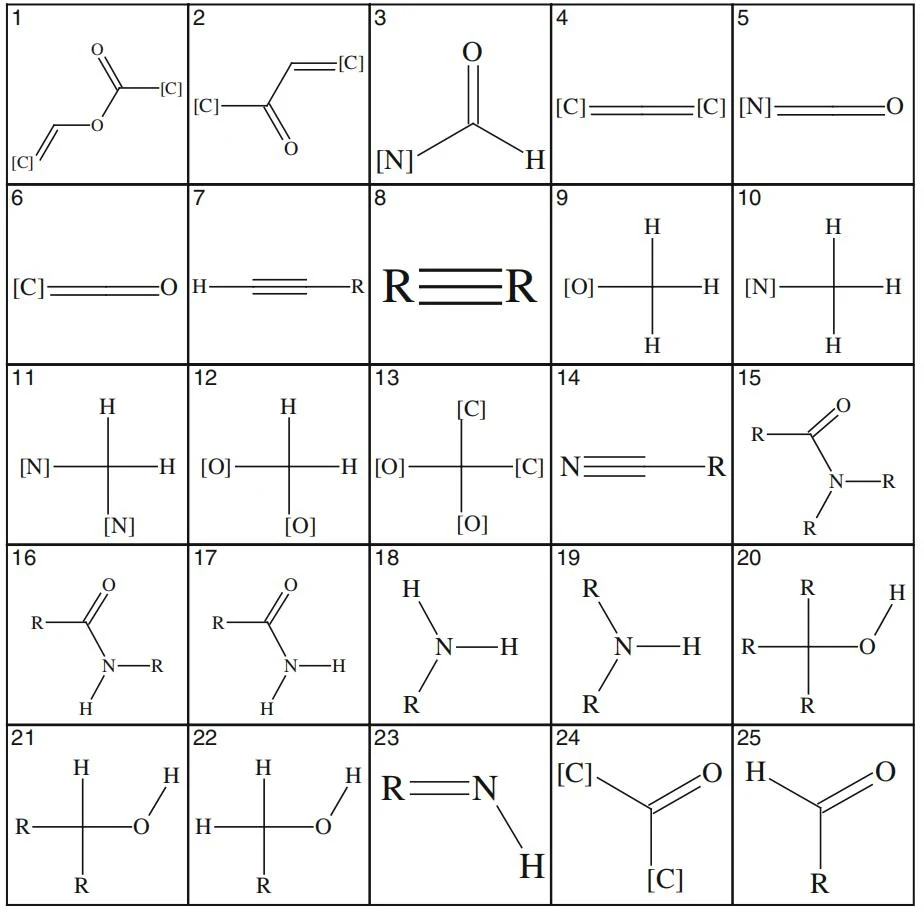
1.3.3.7 典型官能团库为辅助化学家初步关联未知分子与特定化学类别,用户可通过程序功能模块显示分析分子的"整体特征轮廓",即基于13C NMR 谱图对片段库进行搜索后,统计典型功能团在检出片段中的分布频率。通过专用的典型功能团库构建这一整体特征轮廓(示例见图1.10)。高出现频率的基团提示其存在于分子中的可能性较高,而检出片段中完全未出现的基团,若需要,可列入用户自定义的禁用列表(Badlist)。
通过对数据库片段的系统化过滤,该流程还能间接提示某些无法直接从13C 和1H NMR谱图识别的功能团存在。例如,若检出片段中显著富集含–NO2 基团的结构,则应考虑目标分子中可能存在硝基。