
1.4 Structure Elucidator系统中的NMR预测技术
根据实验数据对分子结构施加的约束强度不同,StrucEluc 系统可能输出包含数十至数万个候选结构的文件。由于不同结构中的官能团和分子片段可能具有相似的光谱特征,仅凭化学位移或裂分模式的直观分析难以准确识别目标结构。因此,系统通过将实验谱图与预测谱图进行智能比对,最终筛选出最可能的结构——这一关键步骤通常作为Structure Elucidator 工作流程的最终环节(见图1.6)。
在计算机辅助结构解析(CASE)系统的发展初期,研究者曾面临核心命题的探讨:哪些类型的分子谱图最适用于预测建模,从而在多结构竞争中精准锁定最优解?
理想的谱图预测方法需至少满足以下条件:
(a) 谱图计算速度需足够快,以适用于处理大规模的结构文件。(b) 计算过程应尽可能自动化,最好是完全自动化。(c) 方法的适用性不应依赖于分子大小。(d) 方法的精度需足够高,能够区分相似的候选结构。
研究表明,只有经验性NMR 预测方法能够满足上述目标。质谱(MS)预测无法提供任意化学结构的理论谱图,尽管质谱条件中的诸多变量可能导致不同的裂解途径,但裂解预测更多作为结构鉴定的辅助过滤作用。对红外(IR)光谱预测潜力的研究表明[29],基于价键光学理论[30]的半经验方法以及量子化学方法均无法满足要求(a)–(c),因此应被排除。此外,考虑吸收带强度时,将实验IR 光谱与计算IR 光谱进行比较具有挑战性:相似异构体的IR 光谱通常仅在部分吸收带的形状和强度上存在差异。
20 世纪70 年代,基于加和规则的经验性13C NMR 化学位移预测程序首次出现[31]。与MS 和IR 光谱预测不同,这些方法完全满足(a)–(d) 的要求,且化学位移计算的精度与速度可进一步优化。近二十年来,量子力学(QM)NMR 化学位移计算方法被证明能够以足够精度预测中等分子的NMR 谱图,从而在候选结构中筛选出最优解。
这一进展得益于核磁屏蔽计算中密度泛函理论(DFT)的发展,其中最常用的是规范无关原子轨道(Gauge Independent Atomic Orbital,GIAO)近似[32]。然而,此类方法目前仍较为耗时,只能满足要求(d) 。
经过多个研究团队的持续努力,目前化学界已拥有多种成熟的NMR 预测程序。
1H 和13C 谱图显然是化学家最关注且最常用于结构验证的原子核,因此NMR 预测工具的研发主要聚焦于这两个核种。过去二十年间,NMR 预测软件逐步改进,现已能够提供从合理到卓越的预测精度(详见下文)。光谱学家在结构解析中也会利用其他核种,因此对其他核种(如15N、19F、31P)的化学位移预测(某些情况下还包括耦合常数)也得到发展。Structure Elucidator 系统除支持1H 和13C NMR 的化学位移预测外,还可预测15N、19F 和31P NMR 的化学位移。
在ACD/NMR Predictor 软件中,针对不同核种的NMR 谱图预测均基于三种主要算法实现,这些算法与核种类型无关。
基于加和规则的增量法——增量法是最早建立的预测体系,其理论基础可追溯至
1960 年代提出的线性加和模型[33,34],后经改进引入了偏最小二乘回归(PLS)算法[35,36],通过环境原子增量校正实现化学位移预测。该方法计算过程相对简单,在常规有机分子体系中表现出良好的适用性。
基于HOSE 编码(片段法)的方法——该方法利用包含有机化合物结构式及对应原子(13C、1H 等)实验化学位移的庞大数据库进行预测。每个原子的化学环境通过HOSE(Hierarchical Ordering of Spherical Environments)编码[37] 描述,可识别数据库中与目标分子具有相似化学环境的原子。
基于人工神经网络算法的方法——这些方法在过去二十年间发展起来,通过程序学习实现化学位移预测。训练集用于学习过程,最终生成可高速自动预测化学位移的规则,兼具合理精度[38]。
作为Structure Elucidator 软件的核心组件,ACD/NMR Predictor 整合了上述方法。鉴于增量法已为化学家熟知,本节重点阐述HOSE 编码与神经网络方法的应用机制。
1.4.1 碳谱化学位移预测
1.4.1.1 基于HOSE 编码(片段法)的方法包含化学结构及其对应碳化学位移的数据库构成了该预测算法的基础数据集。对于数据库中每个化学结构中的碳原子,程序根据HOSE 编码生成具有特定层数的以原子为中心的片段(atom-centered fragments,ACF)。这些片段及其对应的化学位移被存储为有序列表,用于预测算法。为了预测候选结构的谱图,程序选择结构中所有可能的ACF,在数据库中搜索其类似物,并通过统计处理将参考片段中的化学位移赋予待预测的碳原子。如果数据库中未找到某个ACF,程序则使用最相似的结构环境进行插值。当使用包含多样化结构的大型数据库时,该方法的结果通常与实验数据高度吻合。
13C NMR 位移预测程序ACD/CNMR Predictor [39]包含一个内部数据文件,其中存储了超过3,018,000 个实验13C 化学位移和123,000 多个表征不同核种相互作用的耦合常数。每个δC 值均预分配到其独特环境中的特定碳原子上。该数据文件来自超过355,000 个化学结构的已归属谱图。程序使用多种算法对内部实验值数据库中未包含的片段进行δC 估算。这些算法及其推导细节属于专有知识,尚未在文献中公开描述,但其一般概念如下所述。
当新化学结构输入ACD/CNMR Predictor 时,程序会自动将其拆分为一组独特片段,并与内部数据库中的结构片段进行比较。
片段匹配:如果绘制的结构中的片段与数据库中的片段完全一致,程序将使用该片段的实验δC 值作为最终化学位移集的一部分。对于此类δC 值,程序不会在化学位移表中显示置信区间。程序为特定碳原子使用半径最多为16 层的参考结构,因此片段的大小由预测结构与参考结构中最大共同片段的大小定义,这些片段均以给定碳原子为中心。
片段搜索与插值:如果结构中的某些片段无法在内部数据库中找到,程序将在数据库中搜索最相似的片段。首先,程序从数据库中生成与分析结构片段在结构上相似的片段集。其次,程序使用二级算法估算结构片段的δC 值,并将其与数据库中选定片段的估算δC 值进行比较,从而缩小到一组相似片段。最后,程序计算实验数据的平均值(δAv),并应用上述第二准则生成估算δC 值。最终δC 值通过结合给定片段的估算δC 值和平均δAv 值计算得出,用于构建结构的最终化学位移集。在生成最终化学位移列表后,ACD/CNMR Predictor 会生成与结构相关的谱线的精确数量、位置、强度及归属信息。
描述NMR 谱图的化学位移、耦合常数和线宽参数受多种外部因素影响,包括溶剂、浓度、温度、弛豫时间、顺磁性杂质浓度、匀场状态和观测频率等。尽管许多因素过于复杂,难以在预测中完全考虑,但溶剂效应可以在一定程度上被纳入预测模型。ACD/CNMR Predictor 提供了溶剂特异性预测功能,用户可从常见NMR 溶剂列表中选择溶剂,并预测其特定条件下的NMR 谱图。此外,分子立体化学构型作为核心结构特征,会显著影响其磁各向异性效应。当输入结构包含明确的原子立体构型信息时,预测算法将自动整合这类三维空间参数,通过构象分析评估其对磁屏蔽效应的贡献度,从而提升预测结果的准确性。
由于许多基础化学研究专注于开发新型分子结构,特定片段可能尚未被文献报道,因而未包含在算法基础数据库中。理想情况下,科学家不仅能捕获和分类自己的结构与归属数据,还能直接将这些信息用于预测算法。为此,ACD/CNMR Predictor 允许用户创建包含结构和归属信息的用户数据库。程序将结构拆分为独特片段,并将新化学位移归属视为内部数据库的更新。当用户数据库处于打开状态时,程序在预测新化学结构的谱图时会优先关注用户数据库中的数据。这种用户数据库训练机制能够显著提升用户实验室对多样化化合物的核磁谱图预测能力——即使这些化合物所含的结构单元在训练数据库中仅以1-2 个代表性子结构存在。该技术实现了双重价值:一方面,通过结构解析过程积累的历史数据可形成可检索的知识库;另一方面,它构建了一个协同研究平台,使机构内众多科研人员能够持续优化预测模型,并共享预测成果。
基于片段法的13C NMR 谱图预测能够为多样化结构生成足够精确的预测结果,通常足以在包含真实结构的候选集中区分出正确结构。然而,该方法的主要缺点是预测速度较慢。例如,当数据库中不存在以下典型天然产物结构时,ACD/CNMR Predictor 在3.4 GHz 的PC 上计算其13C NMR 谱图约需3 秒。
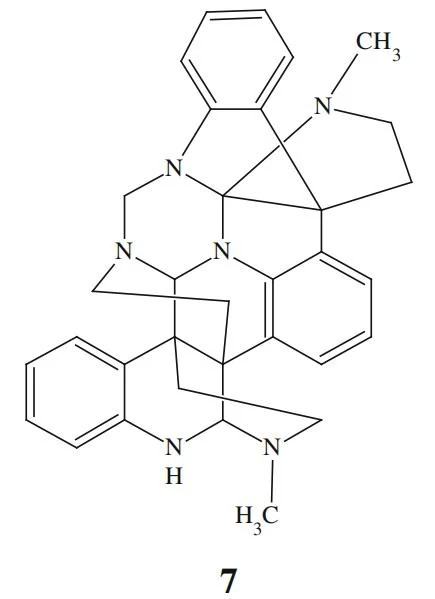
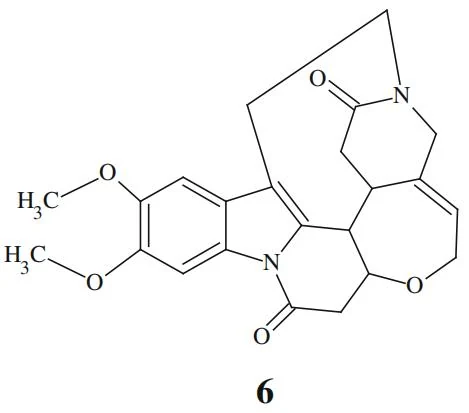
这种计算速度对于单次计算或小批量预测(例如50–100 个结构)而言是可接受的。然而,当需要对数千个假设结构进行谱图预测时,在保持高计算精度的前提下,时间成本将成为显著挑战。如后文(第2.2.2 节)所述,Structure Elucidator 采用多步化学位移预测策略,在初始阶段优先使用增量法和基于神经网络的快速方法,有效解决了这一效率瓶颈问题。
1.4.1.2 人工神经网络(Artificial Neural Networks,ANN)
自20 世纪90 年代初以来,化学家们开始关注计算机化学领域中一种极具潜力的新数学工具——人工神经网络(ANN)。随着研究的深入,ANN 在光谱数据解释、分类和预测(包括NMR 化学位移预测)中的应用迅速增加。
人工神经网络可视为人脑的简化计算机模型,由多层神经元组成,这些神经元根据接收到的输入信号向其他神经元发送信号。图1.11 展示了一个神经网络的流程图。典型的神经网络包括一个包含若干输入神经元的输入层、一个或多个包含隐藏神经元的隐藏层,以及一个输出层。这种网络具有“黑箱”特性,能够构建输入与输出之间关系极为复杂甚至未知的系统的经验模型。
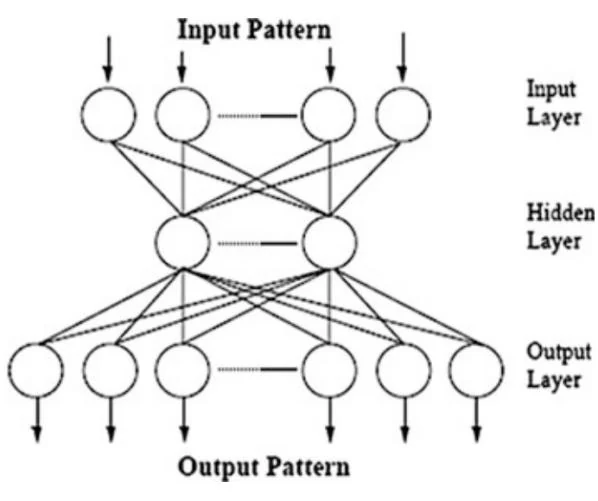
模型的构建通过训练网络实现。在训练过程中,网络以输入-输出对的形式呈现,并通过模拟转换建立关联。经过训练的网络能够根据训练集中未出现的输入示例预测输出信号。训练过程可能耗时较长(数十小时),但一旦训练完成,网络几乎可以即时生成结果。例如,可以训练网络从光谱(输入)中提取结构信息(输出),或从结构信息(输入)中预测光谱(输出)。关于ANN 的理论及其在化学和光谱学中的应用示例,可参考Zupan 和Gasteiger的专著[38]。
人工神经网络通过包含编码结构及其对应谱图的训练集进行训练,以预测化合物的谱图。在训练过程中,网络使用参考结构作为输入信息,并将输出信号与这些结构的13C NMR 谱图进行比较。如果预测谱图与参考集之间的偏差小于选定阈值,则训练过程完成。总体而言,人工神经网络在谱图预测方面的表现略优于线性模型。
通过使用ACD/CNMR Predictor 进行的计算实验,基于HOSE 编码、神经网络(NN)和偏最小二乘法(PLS)算法生成了比较这三种方法性能所需的统计数据[35, 36, 40]。这三种方法的平均误差在1.6 到1.8 ppm 之间,而NN 和PLS 在经过适当优化后可以提供相似质量的结果。
片段法在数据库中代表性不足的结构上表现较差,这会增加平均偏差和最大误差。在这种情况下,PLS 和NN 方法表现更好。如果数据库中包含所有碳原子化学位移计算所需的结构,则基于HOSE 编码的谱图预测具有较高的准确性。
1.4.1.3 13C 化学位移预测速度如前所述,Structure Elucidator 系统基于一维和二维NMR 数据的利用,能够鉴定新分离的天然产物或合成的有机分子。该系统能够解析包含100 个或更多骨架原子的大分子。由于从二维NMR 光谱中提取的初始结构信息本质上是模糊的(见第1.2 节),与二维NMR数据一致的结构数量可能相当庞大(可达数万甚至数十万)。因此,从大量输出文件中筛选最可能的结构需要专家系统采用既准确又快速的NMR 化学位移预测方法。
通过对程序生成的数千个候选结构进行谱图预测,评估了预测速度。结果表明,在3.4 GHz 的PC 上,增量法的13C 化学位移预测平均速度约为每秒30,000 个化学位移,而基于神经网络的算法虽然也较快,但速度约为增量法的1/2.5–1/3。这种高预测速度与适当的精度(平均偏差为1.60–1.80 ppm)相结合,使这两种方法成为计算机辅助结构解析的强大工具。关于如何结合应用这三种NMR 化学位移预测算法来筛选最可能结构的策略,将在第2.2.2 节中详细阐述。
1.4.1.4 化学位移预测方法的比较与优化在化学位移预测领域,不同方法各具特色:基于片段数据库的HOSE 编码方法能够灵活整合新结构,而神经网络方法则需要通过动态重训练来适应新型化学结构类别。相比之下,量子化学方法在预测新类别物质时无需任何调整,展现了其普适性优势。
HOSE 编码方法的核心优势在于其广泛的结构多样性支持,同时充分考虑了被分析分子的立体化学构型。当Structure Elucidator 输出文件为有效解时,该方法为获得正确结构13C NMR 谱图的最小偏差提供了更高可能性。
基于HOSE 编码的软件程序特别提供了预测过程的透明化功能。在Structure Elucidator中,用户可以查看化学位移计算的后台数据调用细节。当对数据库中不存在的化学结构进行预测时,程序会明确显示用于生成预测结果的参考结构及其具体数据。通过比较目标碳原子的化学环境与参考结构的环境和化学位移,研究人员可以深入评估预测结果的可靠性。用户只需右键单击分子结构中的目标碳原子,即可查看完整的后台计算记录。
以天然产物Daphnipaxinin 8 为例,其复杂结构中化学位移65.01、76.00 和179.55 ppm的碳原子,基于HOSE 编码的化学位移预测与实验值存在显著差异(10–15 ppm)。
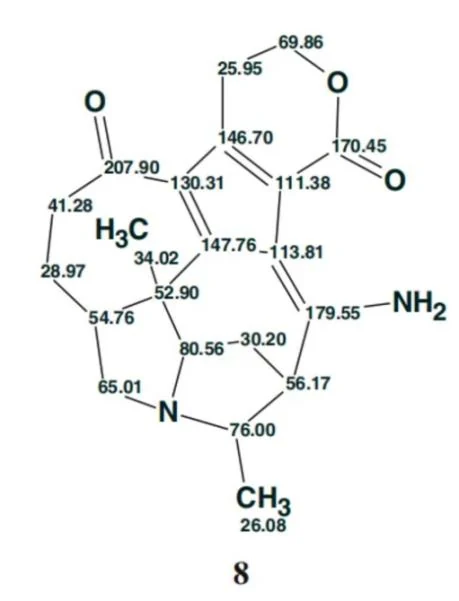
ACD/CNMR 程序预测的化学位移值分别为55.26、61.71 和166.21 ppm。通过计算后台数据调用记录,可以清晰解释实验值与预测值之间显著差异的原因。图1.12 展示了程序为65.01 ppm 处碳原子生成的计算记录。
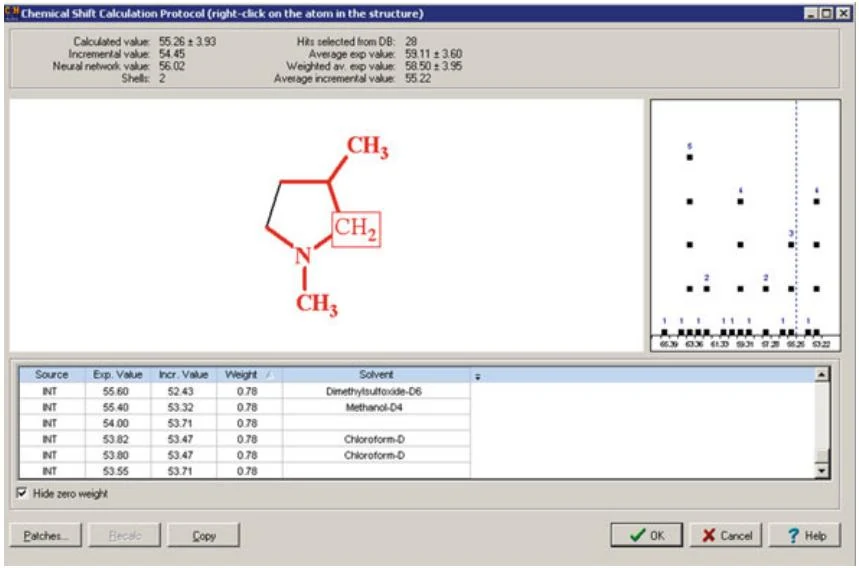
记录显示,程序从数据库中筛选了28 个相关结构用于目标碳核的化学位移预测。直方图展示了用于预测的代表性碳核的化学位移分布情况。图左侧展示了命中结构集中的一个示例结构,其中以目标碳原子为中心(用方框标记)的片段被标为红色。直方图显示,目标碳原子的化学位移分布在53 到66 ppm 之间,计算值为55.26 ± 3.93 ppm。由此可见,数据的广泛分布是导致化学位移预测偏差较大的主要原因。
当查看实验位移为δC = 76.00 ppm 的碳原子的计算记录时,程序显示如下信息(图1.13):
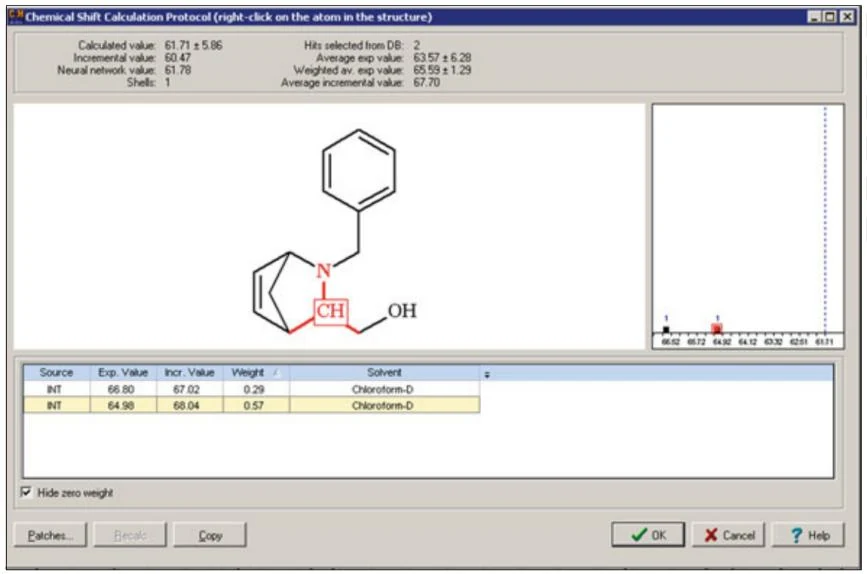
计算记录显示,数据库中仅匹配到两个相关结构,且“工作”片段仅在与目标原子直接相连的一个化学键范围内表现出环境相似性,其参考化学位移值分别为65 和66.8 ppm。基于这些有限数据,程序计算得出目标碳原子的化学位移值为61.71 ± 3.93 ppm,与实验值存在显著差异。对于化学位移为179.55 ppm 的碳原子,程序生成了以下详细计算记录:
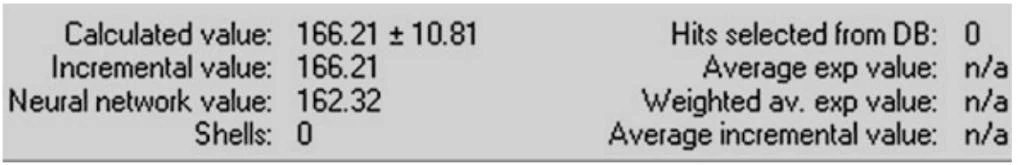
从这一信息可以看出,数据库中未找到包含适合计算目标碳原子化学位移的以碳原子为中心的片段。因此,程序转而采用增量法进行计算,得到δC = 166.21 ppm,与实验值相比存在约15 ppm 的显著偏差。需要强调的是,预测的准确性在很大程度上取决于被分析碳原子中心的环境与参考结构的相似程度。
以化学位移为41.28 ppm 的碳原子为例,程序生成了以下计算记录(图1.14 展示了部分内容):
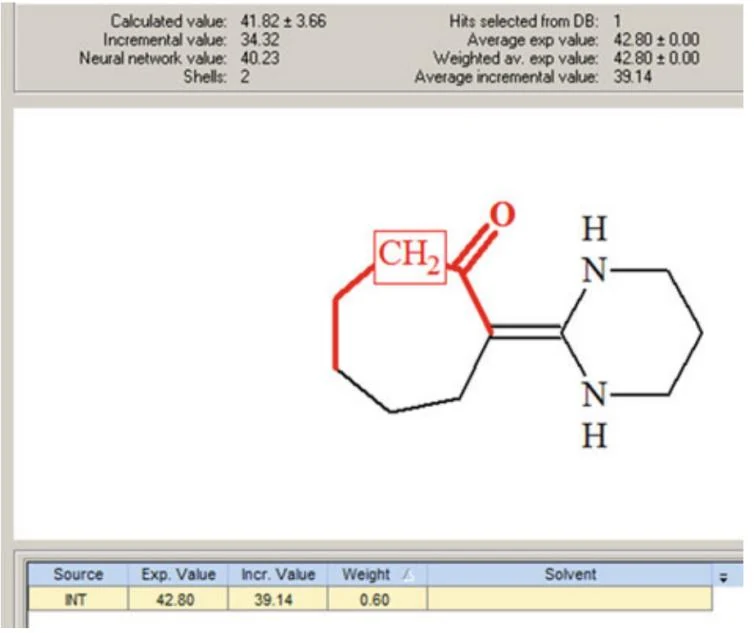
从记录中可以看出,结构8 中目标碳原子的环境与单个参考结构高度相似,因此计算得到的化学位移(41.8 ppm)与实验值(41.28 ppm)非常接近。这一结果表明,当数据库中存在高度匹配的参考结构时,HOSE 编码方法能够提供极为准确的预测结果。
如前所述,神经网络方法以“黑箱”形式运行,无法提供给定碳原子化学位移计算的具体细节。然而,与片段法相比,神经网络在13C NMR 化学位移计算中速度显著更快,这使其在处理大规模化学结构文件时更具效率。尽管如此,正如后文(第三部分)将阐述的,通过合理结合增量法、HOSE 算法及人工神经网络(ANN)方法,可形成最优策略,即使面对超大输出文件,仍能精准锁定正确结构。
1.4.2 氢谱的预测方法
与13C NMR 谱相比,1H NMR 谱的预测及其与实验数据的对比更为复杂。13C NMR 谱主要由单峰或异核耦合产生的清晰多重峰组成,而1H NMR 谱既包含一阶多重峰,也包含高阶复杂多重峰。氢谱的相对复杂性导致实验谱与预测谱的自动化对比难度显著增加,这也解释了为何针对1H NMR 化学位移预测的软件数量远少于13C NMR 化学位移预测工具。
基于HOSE 编码、神经网络和偏最小二乘法(PLS)等算法开发的13C 化学位移预测模型,已被整合至ACD/HNMR Predictor 软件中,用于1H NMR 化学位移计算。ACD/HNMR Predictor(与ACD/CNMR Predictor 类似)作为核心模块嵌入Structure Elucidator 系统。
以下重点阐述基于HOSE 编码的1H 化学位移预测方法特性。与13C 预测类似,该方法依赖大规模数据库实现预测。ACD/HNMR 内部数据库包含近2,176,000 个实验1H 化学位移值和824,000 多个耦合常数。程序通过分析3,000 多个结构片段参数量化自旋-自旋相互作用,数据库中每个δH 值均关联至特定质子核,每个耦合常数对应一对相互作用核。
该数据库源自261,000 张实验1H NMR 谱图的解析结果。对于数据库中未包含的片段,程序通过专有算法计算其质子核的δH 和耦合常数。
1H 化学位移计算可根据谱仪频率进行调整,这一功能通过可选参数设置实现。计算得到的化学位移和耦合常数均附带95%置信区间,用于评估计算值的可靠性。预测谱图考虑了二阶相互作用和远程耦合常数,能够模拟包含8 个磁不等价核的强耦合自旋系统。对于磁等价核,程序可处理更复杂的多自旋相互作用体系。
程序能够自动识别烯烃的顺/反异构体、酰胺/肟/腙/亚硝胺的顺反异构体,以及环状结构的轴向-平伏异构体。此外,程序还支持羟基(OH)、氨基(NH)、巯基(SH)中质子的化学位移预测。对于溶剂效应的处理,程序采用以下方式:若用户指定了溶剂,程序仅选择数据库中该溶剂条件下测得的1H NMR 参考结构进行预测。
1H 化学位移预测算法与13C 预测算法类似。输入目标结构后,程序生成一组独特片段,并与内部数据库中的片段进行比对。若生成的片段与数据库中的片段完全匹配,其实验δH 值将被纳入最终生成的化学位移结果集中。若某些片段未在数据库中找到,则基于相似片段的参数进行外推计算。类似图1.12、1.13 和1.14 所示的化学位移计算记录窗口,允许用户逐项查看每个化学位移的计算过程,这对于分析实验值与预测值之间的偏差具有重要意义。