01 研究背景:PPAPs 与去重复分析的技术选择
多环多异戊烯基酰基间苯三酚类化合物(PPAPs)通常从藤黄科藤黄属(Garcinia)或金丝桃科金丝桃属(Hypericum)植物中分离获得。近期研究显示,PPAPs 如 Guttiferone J(1)是某些 MHC 蛋白的有效调节剂,在免疫治疗领域具有潜在研究价值。然而迄今已报道的 618 种 PPAPs 衍生物结构复杂、市场可获得的种类极少,深入探索其化学多样性亟需高效的提取物快速筛查手段。
传统 LC-MS² 去重复方案对 PPAPs 存在先天局限:其不对称中心与异戊烯基/香叶基取代常导致难以区分的碎片模式,立体异构体无法通过质谱鉴定。相比之下,¹³C-NMR 化学位移(δC)受溶剂影响小、信号重叠罕见,且能区分立体异构体——这为发展基于 ¹³C-NMR 的去重复策略提供了依据。实施该策略的关键在于:去重复需要依托数据库,而数据库该怎么选?
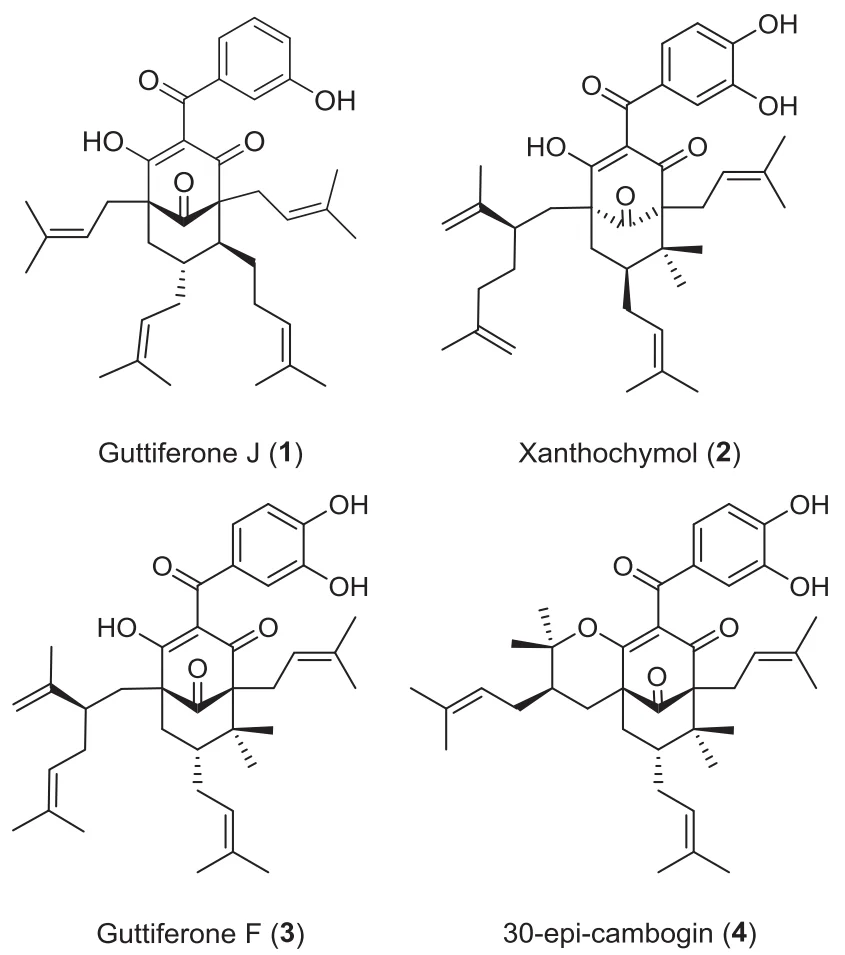 图1. 从藤黄属植物 Garcinia bancana 树皮中分离得到的化合物结构:guttiferone J(1)、xanthochymol(2)、guttiferone F(3)和 30-epi-cambogin(4)
02 三类 ¹³C 数据库的对比与本研究设计
文献中去重复分析可选用的 ¹³C 数据库有三类:内部数据库(相同氘代溶剂与参数下准确度可达 0.1 ppm,但复杂混合物难以保持相同条件且难以完备);文献实验数据库(构建耗时,且 PPAPs 数据分散于吡啶-d₆、氘代氯仿、甲醇-d₄ 等不同溶剂体系,存在显著的溶剂依赖性差异);预测数据库(由 ¹³C-NMR 预测软件构建,但此前缺乏充分论证)。
为系统评估预测数据库的可靠性,本研究选取 80 种结构多样的藤黄科/胡桐科天然产物(涵盖苯甲酮、联苯、色原酮、香豆素、缩酚酸、PPAPs、生育三烯酚、三萜和呫吨酮九类结构),分别构建实验数据库(DB1)与预测数据库(DB2)。预测数据库采用三种软件:ACD/Labs(2014 版)、MestReNova NMRP 模块(v12.0.1)和 ChemDraw Professional(v17.0),通过计算实验值与预测值的绝对差异评估预测准确性。
03 预测准确性对比:ACD/Labs 以 ±1.25 ppm 精度覆盖 73% 碳信号
对 80 种天然产物的系统分析显示,三种预测软件的准确性呈现显著差异:
- ACD/Labs 表现最优:平均而言,73% 的预测碳信号与文献报道值的偏差小于 1.25 ppm;
- MNova 与 ChemDraw 需在 ±2.00 ppm 和 ±3.00 ppm 的偏差范围内才能达到相当的覆盖率;
- 预测准确性主要受化合物结构类型影响(p<0.01),而与碳原子的杂化类型无显著相关性(p>0.05)。
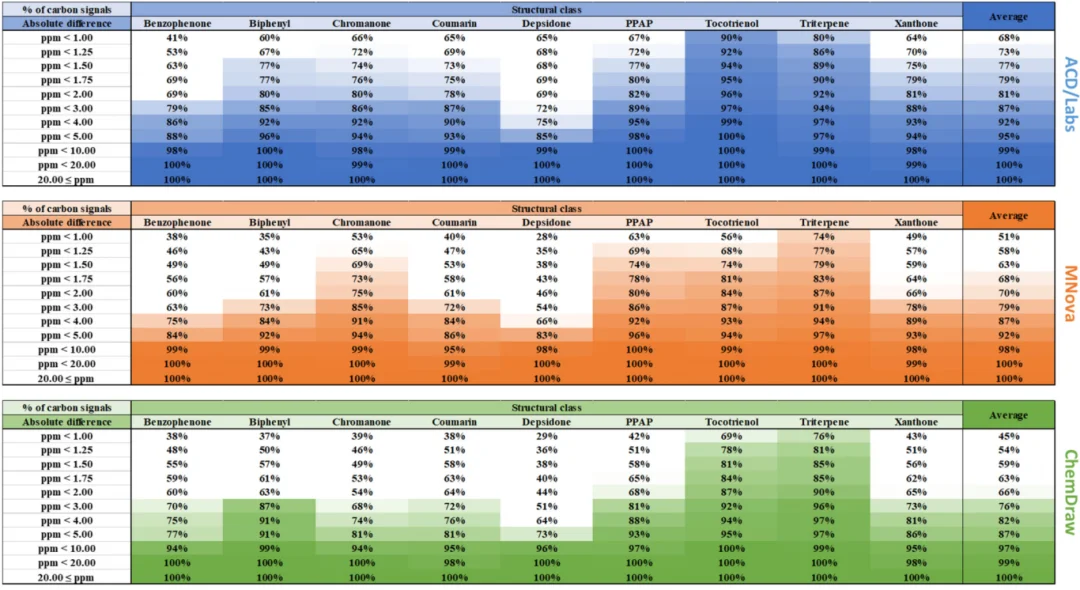 表1. ACD/Labs(蓝)、MNova(橙)和 ChemDraw(绿)三种预测软件在给定偏差区间内对碳信号的预测百分比。以 ACD/Labs 为例,平均 73% 的预测碳信号与文献值偏差小于 1.25 ppm(基于 80 种藤黄科/胡桐科天然产物测试数据)
04 Garcinia bancana 提取物的去重复验证:预测数据库 vs 实验数据库
基于上述参数标准(允许偏差 ±1.25 ppm、匹配 75% 碳信号),研究团队对 Garcinia bancana 树皮二氯甲烷提取物的 10 个亚组分进行 ¹³C-NMR 去重复分析(JEOL 400 MHz 谱仪,16,000 次扫描)。通过 Microsoft Excel 宏实现数据分箱自动化,采用层次聚类分析(HCA)确定四个主要代谢物簇——每个数据集对应一种独立的分子结构。
随后将各簇的化学位移数据集分别在两个数据库中检索:预测数据库 DB3(用 ACD/Labs C+H NMR Predictor 模块,基于 Dictionary of Natural Products 收录的 718 种藤黄属天然产物构建)与实验数据库 DB4(JEOL CH-NMR-NP 数据库,收录 2000–2014 年发表的约 30,500 种天然产物)。
通过分离纯化得到的主要 PPAPs(xanthochymol、guttiferone F 和 30-epi-cambogin,MSI 级别 1)验证发现:预测数据库 DB3 正确识别了 xanthochymol、guttiferone F 的立体异构体(garcinol 或 guttiferone E)以及 30-epi-cambogin 的异构体(cycloxanthochymol);而实验数据库 DB4 仅识别出 guttiferone F 的异构体(garcinielliptone FC)和 30-epi-cambogin 的立体异构体(isogarcinol)——由于 JEOL 实验数据库未包含该粗提物中的所有化合物,完全匹配无法实现。两个数据库都能识别 PPAPs 的结构类型,但对具体异构体的预测存在差异。
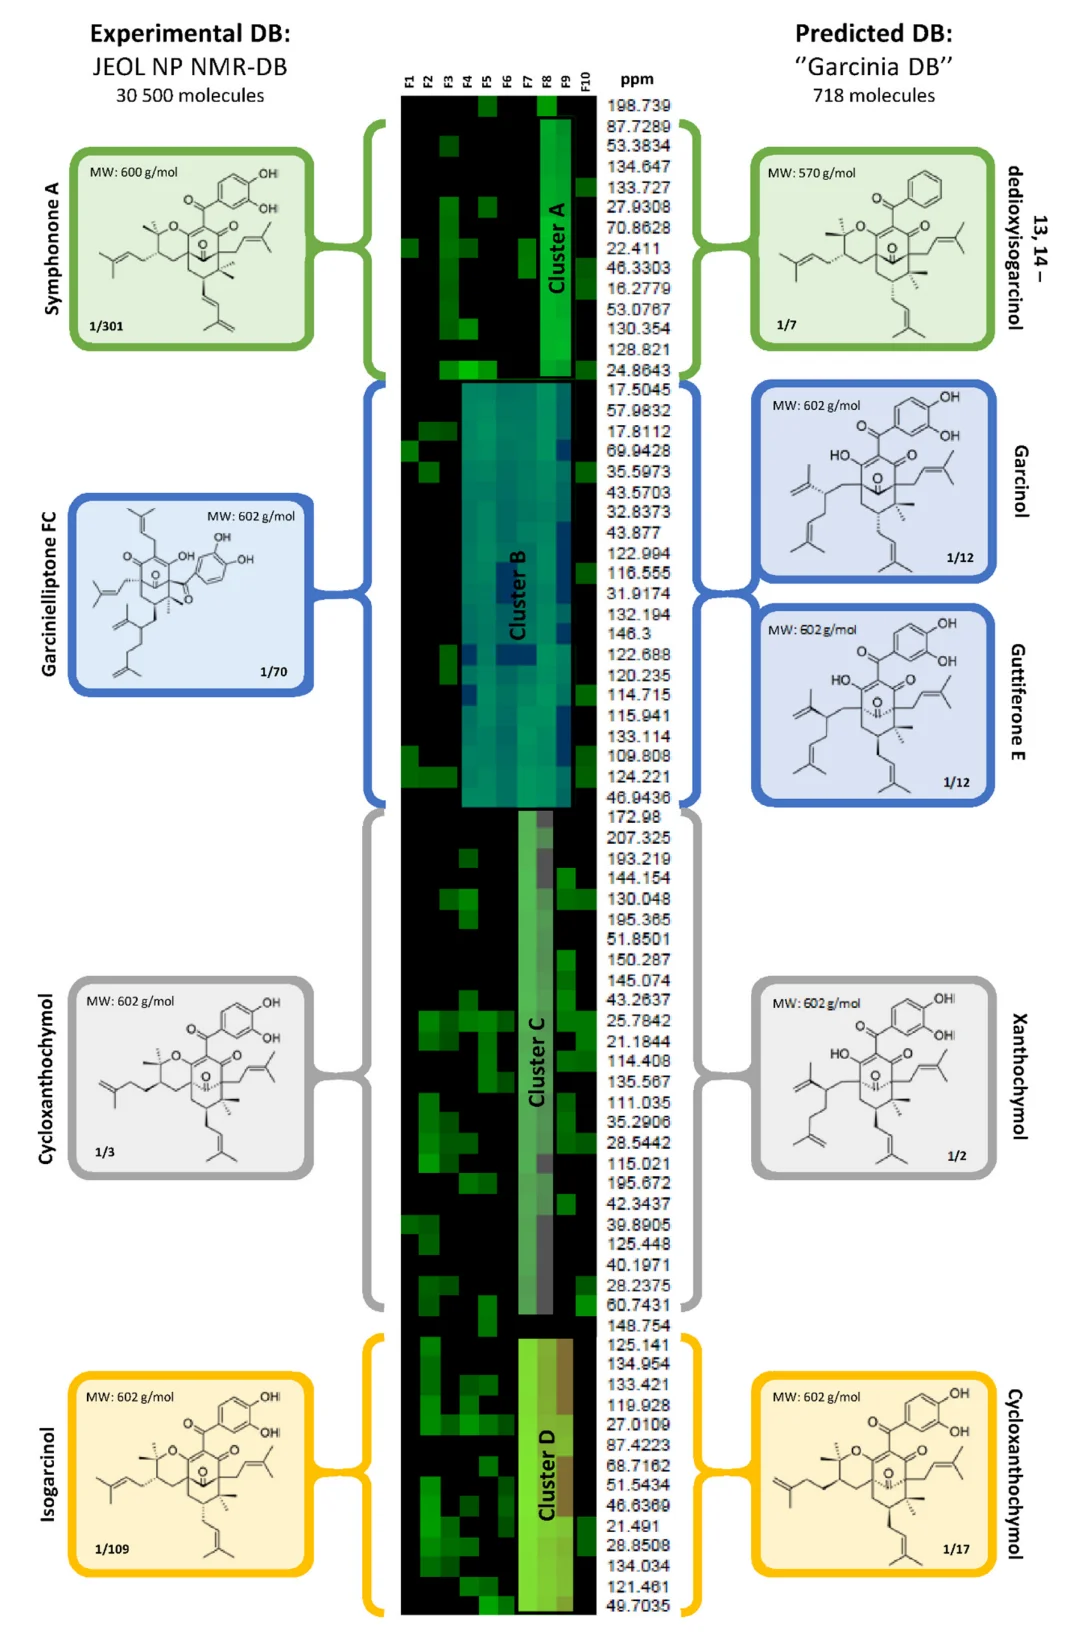 图2. 实验数据库(左,JEOL NP NMR-DB,30,500 个分子)与预测数据库(右,"Garcinia DB",718 个分子)对各代谢物簇的首推分子结构。以簇 A 为例,预测数据库从 718 个分子中给出 7 个潜在匹配,13,14-脱氧异藤黄醇匹配度最高
05 结论与启示
- LC-MS² 分析无法区分 PPAPs 的不同立体异构体,需要特定数据库支撑的 ¹³C-NMR 去重复分析;
- 实验数据库在相同溶剂条件下可获得更佳匹配,但其构建耗时且难以穷尽所有化合物;
- 本研究首次证实预测数据库至少可作为初步去重复的有效替代方案:ACD/Labs 预测数据(75% 的 δC 偏差在 ±1.25 ppm 内)足以识别 G. bancana 粗提物中的主要 PPAPs;
- 针对藤黄科和胡桐科天然产物,不同软件的预测精度存在显著差异,选择预测工具前应先做准确性评估。
凯美科提示:当实验数据库覆盖不足、或混合物体系难以保持一致溶剂条件时,用 NMR Predictors 构建预测型 ¹³C 数据库是快速可行替代路径。凯美科为医药、化工、食品等领域用户提供 ACD/Labs 全线产品的演示与技术服务,如需就实际样品体验预测数据库构建与去重复分析流程,欢迎联系我们。
参考资料
- 原始论文:Bruguière A, Derbré S, Coste C, et al. ¹³C-NMR dereplication of Garcinia extracts: Predicted chemical shifts as reliable databases. Fitoterapia.(第一作者/通讯作者单位:法国昂热大学 SONAS SFR QUASAV;合作单位:法国昂热大学 SFR MATRIX、马来亚大学化学系,吉隆坡)
- 本文整理自微信公众号「凯美科」发布的文献分享文章。
- 关键技术:ACD/Labs C+H NMR Predictor(预测数据库构建)、¹³C-NMR 去重复分析、层次聚类分析(HCA)。
相关案例
