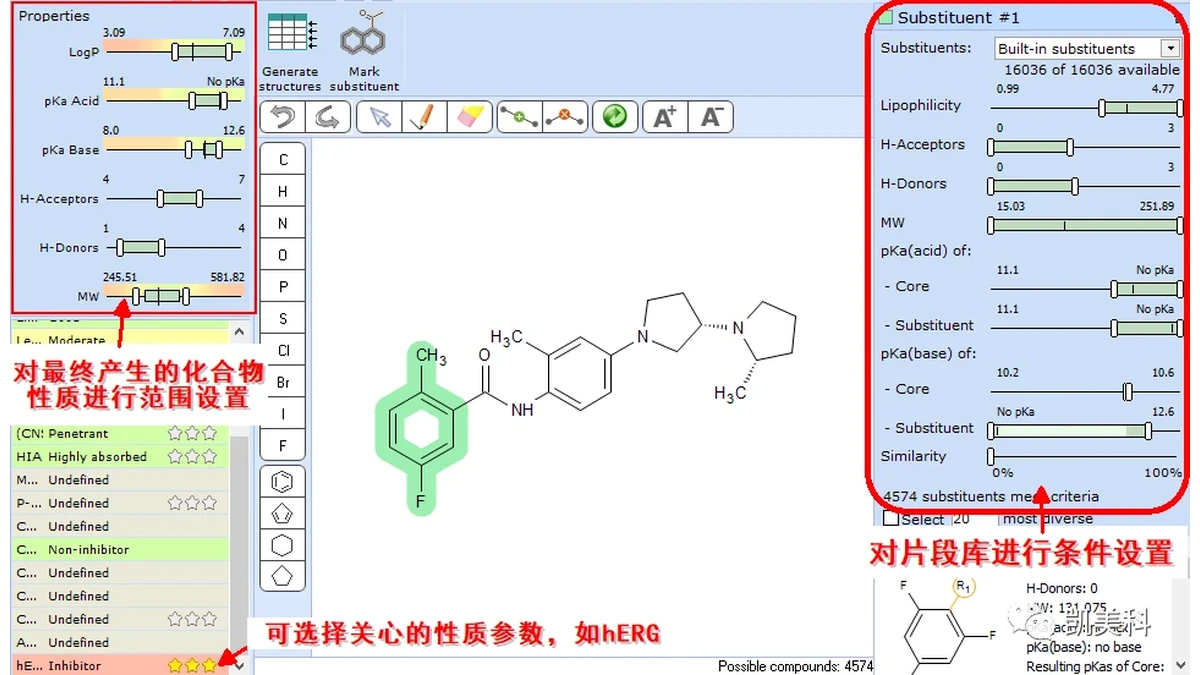
集成于 Percepta 平台的先导化合物结构优化工具:在先导物结构上标记待修饰位点,从内置或自定义片段库生成虚拟类似物库,按理化、ADME 与毒性性质目标批量预测、排序与筛选,在合成之前把资源集中到最可能达标的衍生物上。新版引擎(Structure Design Engine)可在数秒内探索 10¹⁶ 量级的虚拟化合物空间。
从标记位点、生成类似物库到批量性质筛选的先导优化闭环,预测能力由 Percepta 各预测模块提供。
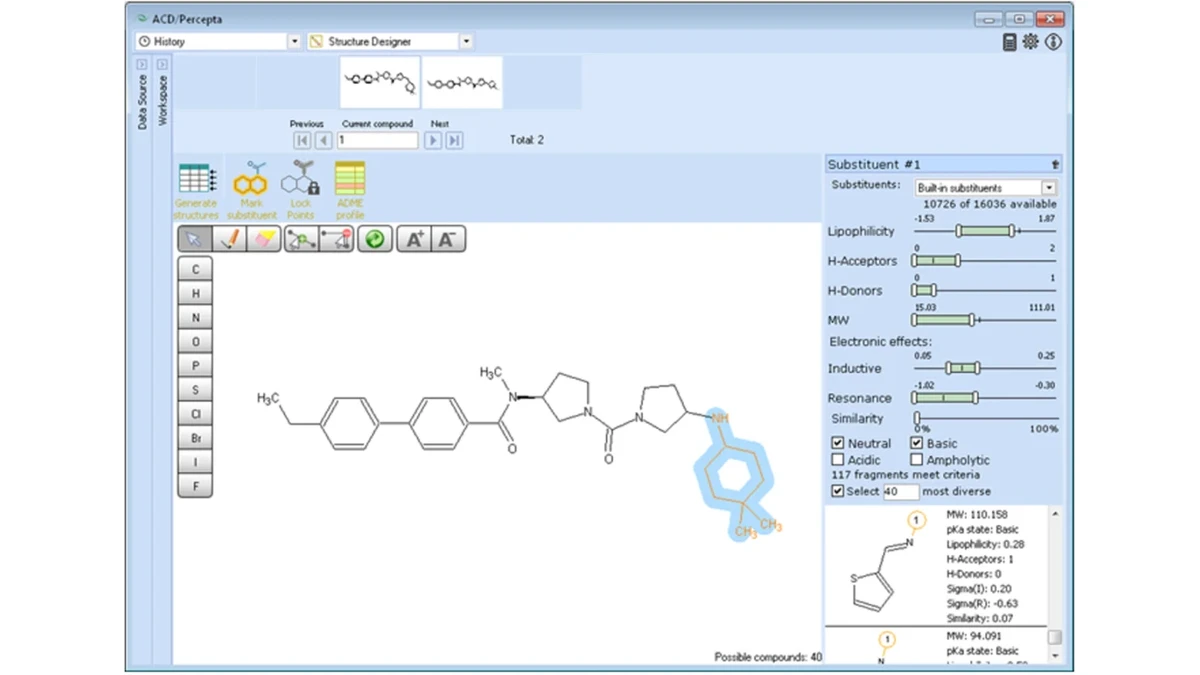
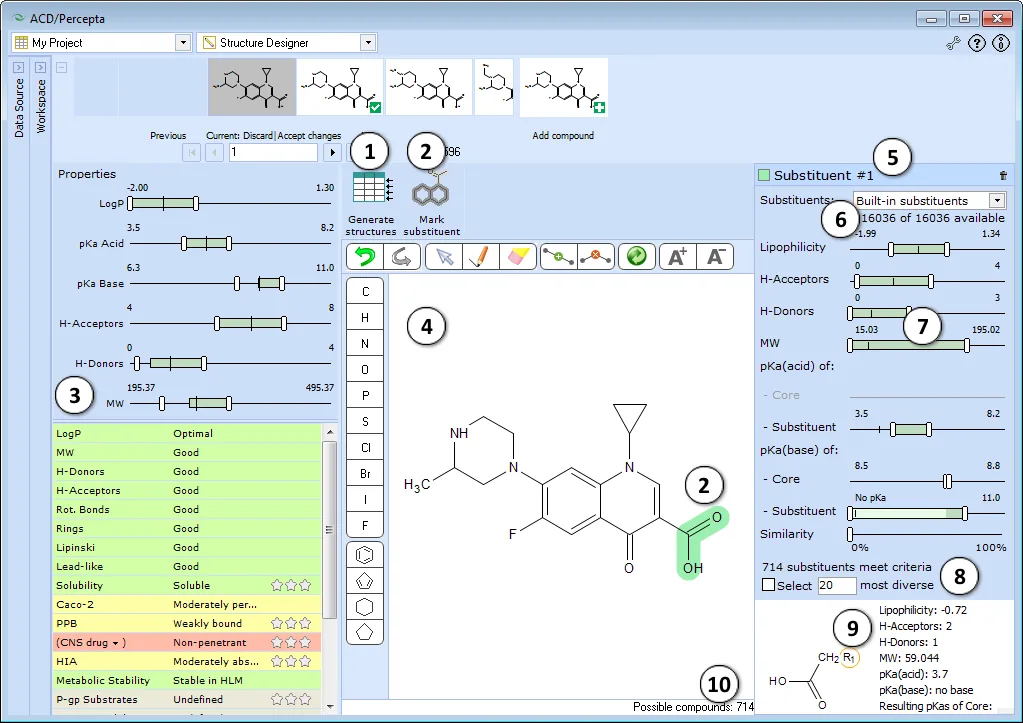
Structure Designer 的典型工作界面截图。
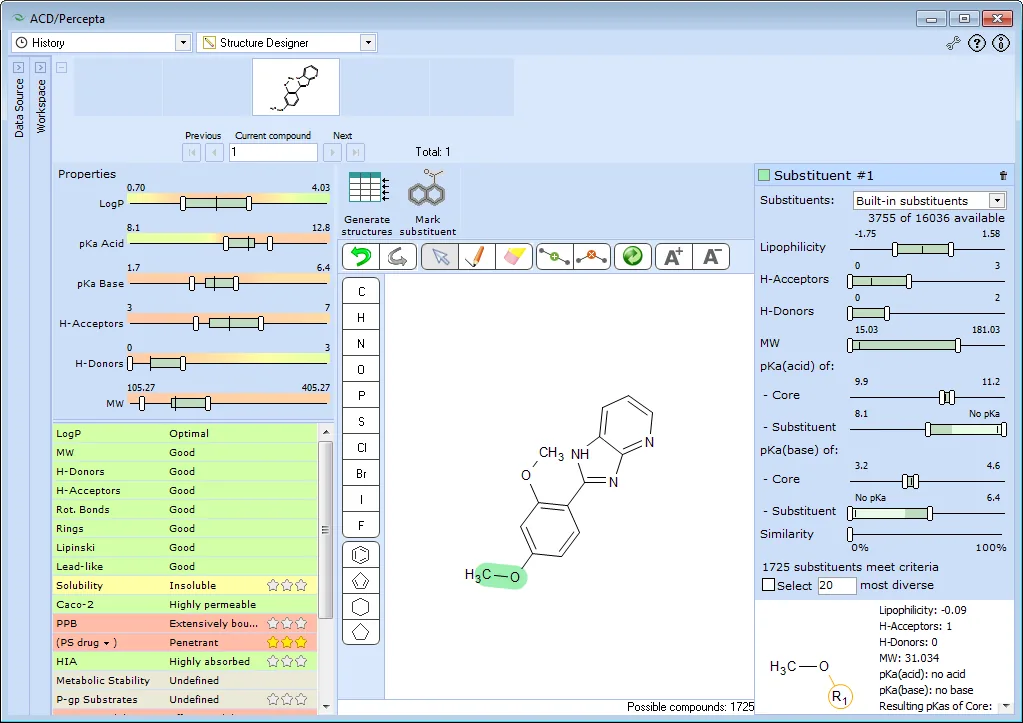
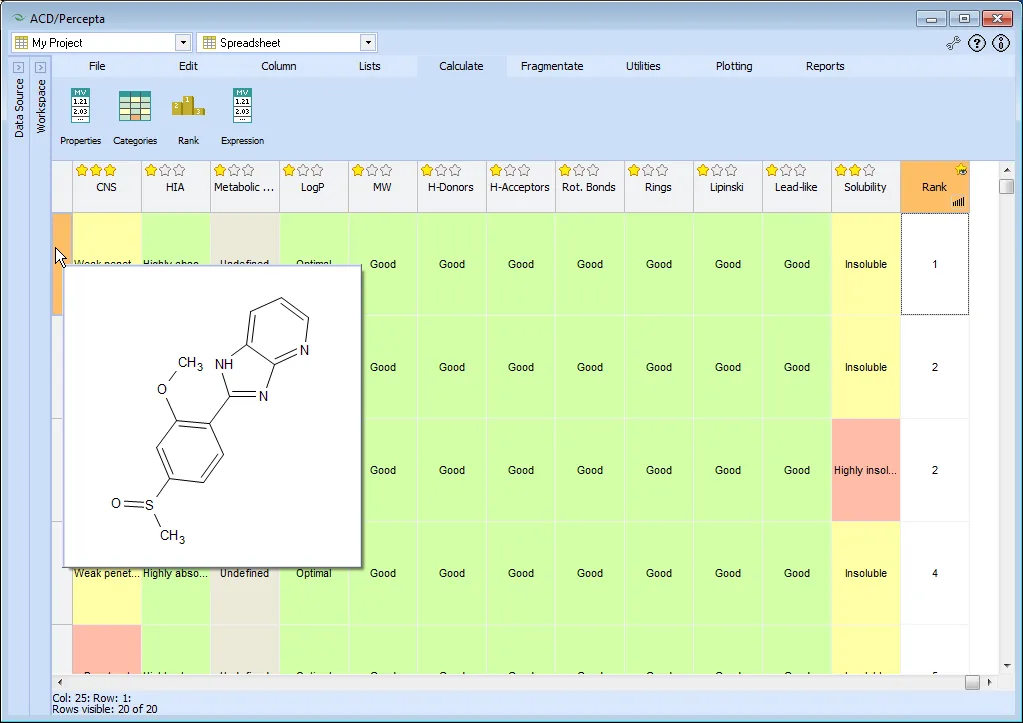
把结构优化从「依赖个人经验」变为「以性质数据驱动」的设计流程。
在合成新衍生物之前预判结构修饰方案的可行性,避免把合成与测试资源花在大概率不达标的化合物上。
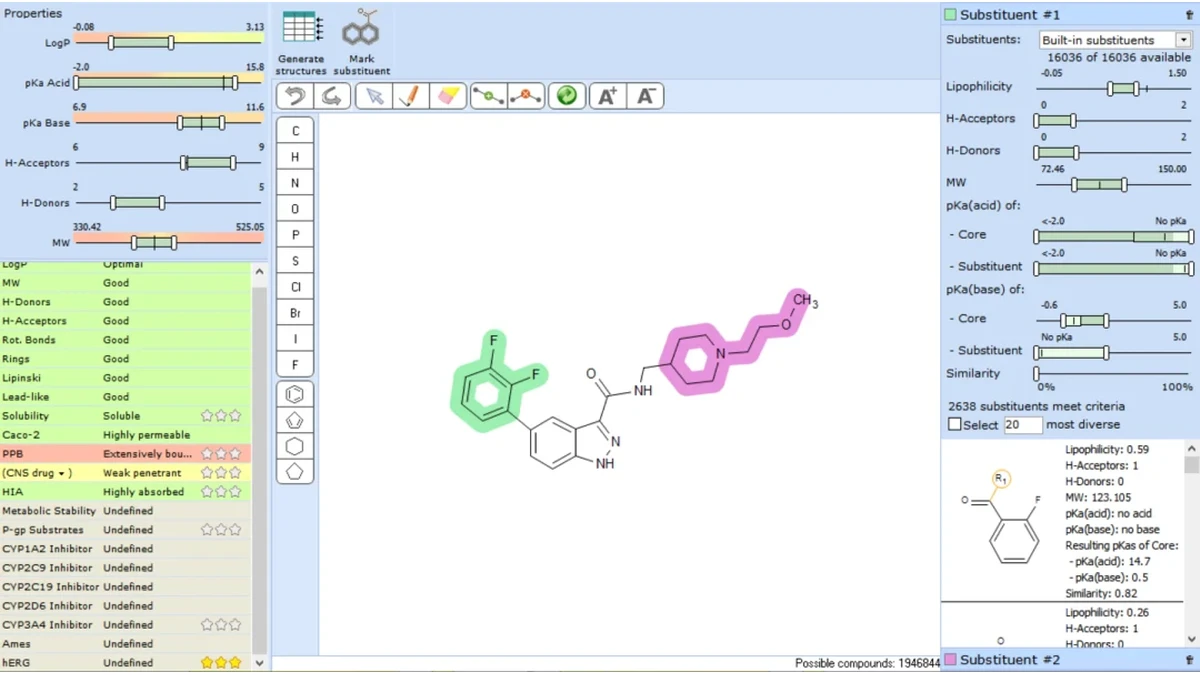
logP、pKa、溶解度、渗透性、hERG 等目标常常此消彼长。以星级权重与允许范围同时约束多个性质,颜色映射直接指出性质空间中的优势区域。
不预设单个取代基性质限制的枚举策略,在整体分子性质受控的前提下最大化类似物库的结构多样性,减少遗漏潜在类似物的风险。
| 模块定位 | 集成于 Percepta 平台的结构生成与先导化合物优化工具,预测能力调用 PhysChem / ADME / Tox 各预测模块(详见产品线介绍) |
|---|---|
| 取代基(片段)库 | 内置 16,000+ 药物分子片段库;可基于逆合成反应规则自建片段库,或由内部化合物库、试剂目录制备构建块集合;每个修饰位点可独立指定片段库与过滤条件 |
| 并行修饰位点 | 最多 4 个取代位点同时枚举,各位点可设置独立的性质范围与相似度过滤器 |
| 枚举规模与性能 | 新一代 Structure Design Engine 将复杂度由 O(n⁴) 降至约 O(n²),内置库规模下总组合数可达 6.6×10¹⁶,可在数秒内完成全空间探索并保持交互式操作体验 |
| 优化目标设定 | 按性质设定允许范围(滑块)与重要性(星级权重);支持「CNS 药物 / 外周药物」目标切换;性质标尺颜色映射指示有利区域 |
| 结果评估工具 | 批量预测与综合排序、成药性分类颜色标记、可靠性指数(RI)与相似结构对照、散点图 / 排序 / 筛选;支持导入已测活性数据合并排序 |
| 输入与输出 | 内置结构绘制,或由 MOL / SK2 / SKC / CDX 等文件导入;生成的衍生物库可导出 SDF,供分子对接、QSAR 等外部虚拟筛选流程继续使用 |
由公众号文章迁移整理,介绍虚拟类似物库的构建方法与操作流程。
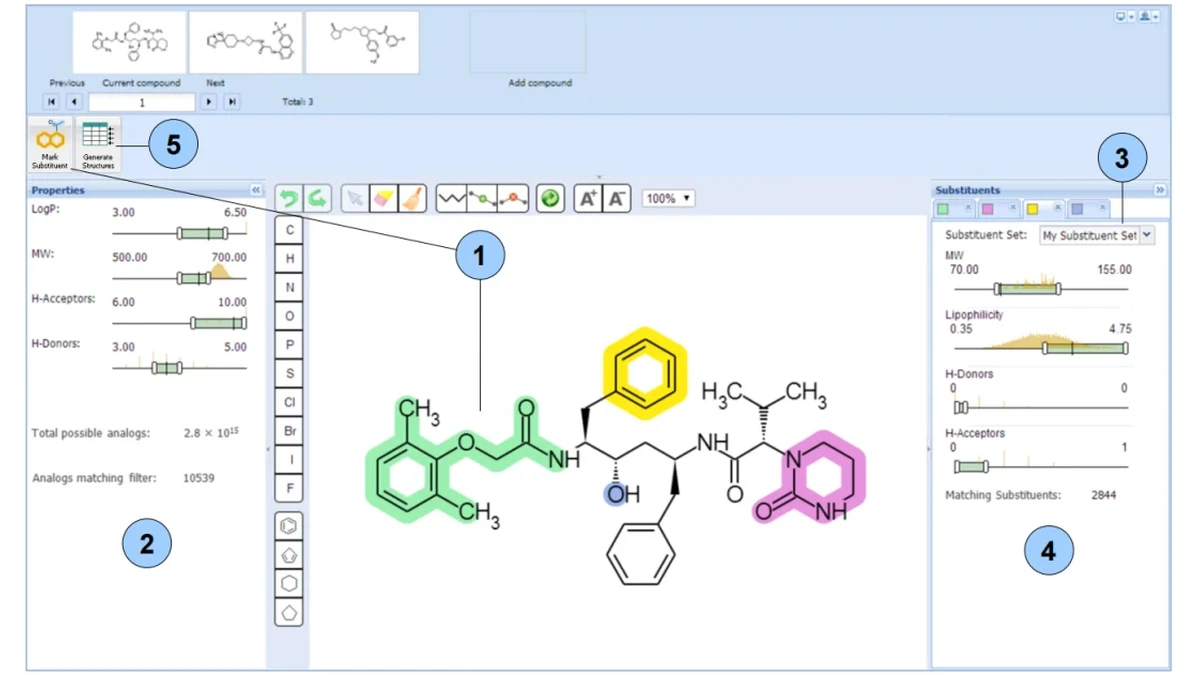
新一代引擎把虚拟类似物生成与性质预测排序耦合:最多四个位点并行枚举,复杂度降至约 O(n²),数秒探索 10¹⁶ 量级化学空间。
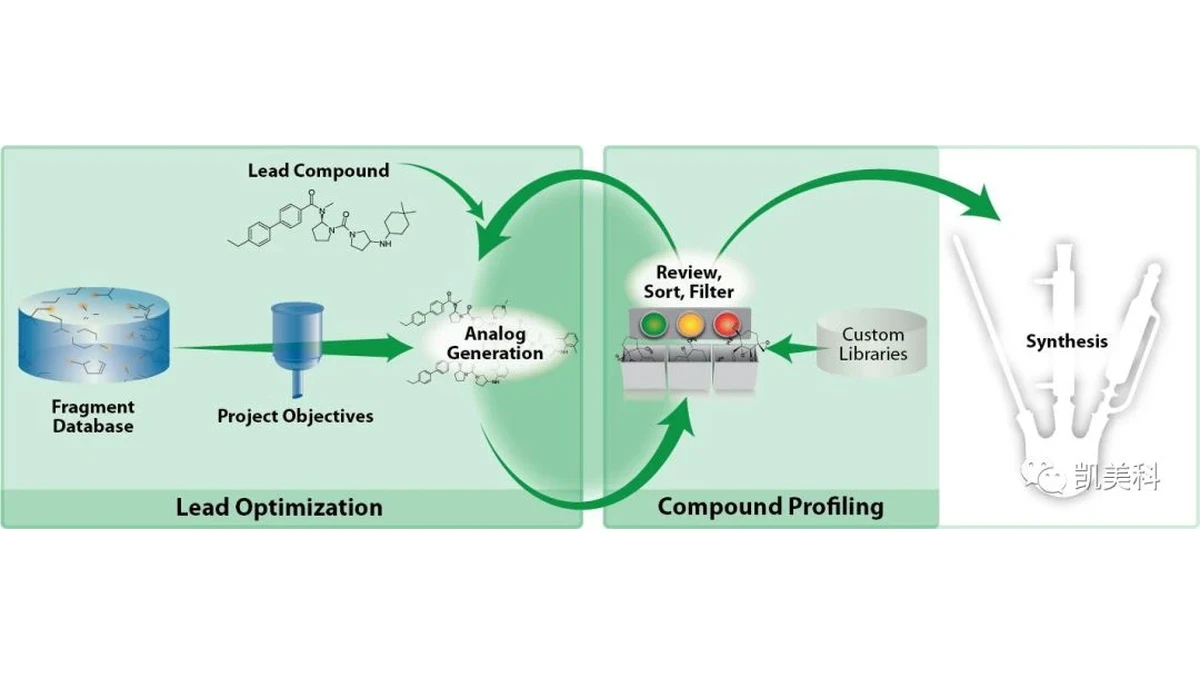
以组胺 H3 受体拮抗剂先导物为例的五步操作演示:结构导入、位点选取、片段库设置、5410 个衍生物生成与批量 hERG 风险筛选,并介绍自建片段库。